---
# Só mude aqui!!!!
author: "Otávio Neiva e Gregório Grazziotti"
title: "Relatório de Aula Prática 03"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "07/09/2026, 18:00"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
## 📌 Introdução
A garantia da segurança estrutural, do desempenho mecânico e da durabilidade do concreto armado em obras de infraestrutura e edificações depende da rigidez metodológica aplicada ao controle tecnológico dos materiais cimentícios [@NBR12655; @NBR6118]. A verificação sistemática da consistência no estado fresco pelo ensaio de abatimento do tronco de cone (*Slump Test*) [@NBR16889] e da resistência à compressão axial ($f_c$) no estado endurecido aos 7, 14, 28 e 56 dias [@NBR5738; @NBR5739] constitui a base normativa para a comprovação da conformidade das misturas em relação à resistência característica de projeto ($f_{ck}$) [@NBR8953].
Entretanto, nos canteiros de obra, a coleta descentralizada de dados operacionais conduzida por múltiplos profissionais frequentemente introduz um ruído amostral significativo [@Mehta2014]. Inconsistências como valores ausentes ($NA$), desvios categóricos em strings, incorreções de escala decimal e a inserção involuntária de caracteres alfanuméricos em campos quantitativos corrompem as variáveis do banco de dados. Em um ambiente computacional estritamente tipado como a linguagem R [@R2024], a presença de um único caractere indevido em uma coluna quantitativa desencadeia a coerção implícita para o tipo *character*, impossibilitando o cálculo direto de métricas estatísticas essenciais para a tomada de decisão técnica [@Wickham2017; @Wickham2019].
Para superar esses gargalos, este relatório aborda a aplicação de uma rotina moderna e integrada de Ciência de Dados orientada à Engenharia Civil. Utilizam-se prioritariamente as ferramentas da família **tidyverse** — integrando os pacotes `readr` (leitura e parsing), `dplyr` (manipulação funcional), `tidyr` (organização de dados), `stringr` (tratamento de texto), `purrr` (programação funcional) e `ggplot2` (visualização gráfica) [@Wickham2019] — combinadas ao operador *pipe* nativo (`|>`).
A análise abrange uma amostragem de 100 corpos de prova e 10 variáveis de controle tecnológico, articulando o diagnóstico e a higienização dos dados às leis físico-químicas da tecnologia do concreto, como a Lei de Abrams [@Abrams1918; @Neville2016].
## 🎯 Objetivos
### Objetivo Geral
Desenvolver e aplicar uma rotina automatizada e reprodutível de inspeção, diagnóstico, higienização, transformação e exploração de dados do controle tecnológico do concreto, utilizando prioritariamente os pacotes da família **tidyverse** (`readr`, `dplyr`, `tidyr`, `stringr`, `purrr` e `ggplot2`) [@Wickham2019] e o operador *pipe* nativo (`|>`), visando transformar registros operacionais brutos provenientes de canteiros de obra em informações estruturadas e confiáveis para o suporte à tomada de decisão na Engenharia Civil.
### Objetivos Específicos
- **Inspecionar a estrutura e a qualidade da base bruta:** Carregar o registro primário com `read_csv2()`, avaliar a tipagem e dimensão da matriz amostral via `glimpse()` e mapear sistematicamente a ocorrência de valores ausentes ($NA$) utilizando `across()`.
- **Implementar rotinas automatizadas de limpeza e padronização:** Corrigir erros de digitação, substituir caracteres indevidos, remover espaços adicionais e padronizar categorias com funções do pacote `stringr` (`str_trim()`, `str_to_upper()`, `str_replace_all()`), convertendo colunas quantitativas coagidas com `parse_double()`.
- **Corrigir anomalias e desvios de escala:** Identificar e realinhar erros de ordem de grandeza e deslocamento decimal em variáveis reológicas e físico-mecânicas (idade, consumo de cimento, abatimento, densidade e absorção) com `if_else()`.
- **Executar imputação condicional estocástica de dados faltantes:** Preencher registros ausentes ($NA$) com base nas médias amostrais de cada traço nominal (`tipo_concreto`) via `group_by()` + `mutate()`, preservando a esperança matemática intra-classe $\mathbb{E}[X | G_k]$ e a potência estatística da amostragem sem descartar observações [@Little2019].
- **Desenvolver variáveis derivadas de conformidade estrutural:** Criar indicadores adimensionais de Resistência Relativa ($R_{rel} = f_{c,obs} / f_{ck}$) e classificação booleana de aceitação normatizada perante a ABNT NBR 12655 [@NBR12655] e ABNT NBR 6118 [@NBR6118] empregando `mutate()` e `case_when()`.
- **Analisar o comportamento físico-mecânico e reológico:** Agrupar e sumarizar variáveis quantitativas com `group_by()`, `summarise()` e `across()`, correlacionando o consumo de cimento e o fator água/cimento ($\text{a/c}$) com os preceitos teóricos da Lei de Abrams [@Abrams1918; @Neville2016] e produzindo visualizações gráficas de alto desempenho com `ggplot2`.
---
## 📚 Fundamentação Teórica
A análise e o processamento de dados do controle tecnológico do concreto exigem um duplo embasamento: o rigor das diretrizes normativas e leis físico-químicas da Engenharia Civil, combinado aos princípios modernos de Ciência de Dados e programação funcional do ecossistema **tidyverse** [@Wickham2017; @Wickham2019; @R2024].
---
### Normatização e Controle Tecnológico do Concreto (ABNT)
O controle de qualidade e recebimento do concreto no Brasil é regulamentado por um conjunto de normas técnicas da Associação Brasileira de Normas Técnicas (ABNT):
- **ABNT NBR 8953:** Classifica os concretos para fins estruturais em grupos de resistência [@NBR8953]. As classes analisadas neste estudo ($C25, C30, C35, C40$) pertencem ao Grupo I (concretos de resistência normal), em que o número nominal representa a resistência característica à compressão ($f_{ck}$) especificada em megapascals ($\text{MPa}$) aos 28 dias de cura.
- **ABNT NBR 12655:** Estabelece os procedimentos de preparo, controle, recebimento e aceitação do concreto [@NBR12655]. Define os critérios de amostragem e ensaios para verificação da conformidade dos lotes de concretagem.
- **ABNT NBR 5738 e NBR 5739:** Padronizam, respectivamente, a moldagem e cura de corpos de prova cilíndricos e o ensaio de compressão axial para determinação da resistência mecânica ($f_c$) [@NBR5738; @NBR5739].
- **ABNT NBR 16889:** Regulamenta o ensaio de abatimento do tronco de cone (*Slump Test*) para avaliação da consistência e trabalhabilidade do concreto no estado fresco [@NBR16889].
- **ABNT NBR 6118:** Fixa os requisitos básicos para o projeto de estruturas de concreto e prescreve os parâmetros de amadurecimento mecânico e durabilidade da estrutura [@NBR6118].
---
### Leis Físico-Químicas da Tecnologia do Concreto
#### Lei de Abrams e Relação Água/Cimento ($\text{a/c}$)
Formulada por Duff Abrams [@Abrams1918], a lei fundamental da tecnologia do concreto estabelece que a resistência à compressão de uma mistura totalmente adensada é inversamente proporcional à razão entre o volume de água livre e o volume de cimento [@Mehta2014; @Neville2016]:
$$f_c = \frac{A}{B^{(\text{a/c})}}$$
Onde $f_c$ representa a resistência à compressão axial ($\text{MPa}$), $\text{a/c}$ é a relação água/cimento em massa ($\text{kg/kg}$) e $A, B$ são constantes empíricas características dos materiais constituintes e das condições de ensaio. A redução do fator $\text{a/c}$ diminui a porosidade capilar da pasta endurecida e eleva a resistência mecânica final.
#### Consumo de Cimento ($C$) e Densidade Aparente ($\rho$)
O consumo de cimento por metro cúbico ($C$, em $\text{kg/m}^3$) relaciona-se com a densidade aparente do concreto fresco ($\rho$, em $\text{kg/m}^3$) e com a proporção dos materiais no traço em massa ($1 : m : \text{a/c}$) [@Helene1992]:
$$C = \frac{\rho}{1 + m + \text{a/c}}$$
Onde $m$ representa a proporção total de agregados secos (miúdo + graúdo) em relação à massa de cimento.
#### Critério de Conformidade e Aceitação Estrutural
Para a verificação individual e loteada de cada corpo de prova perante a especificação de projeto ($f_{ck}$), define-se o indicador adimensional de **Resistência Relativa** ($R_{rel}$) [@NBR12655; @NBR6118]:
$$R_{rel} = \frac{f_{c,obs}}{f_{ck}}$$
$$\text{Classificação} = \begin{cases} \text{"Conforme"}, & \text{se } R_{rel} \ge 1{,}0 \\ \text{"Não Conforme"}, & \text{se } R_{rel} < 1{,}0 \end{cases}$$
---
### Ciência de Dados e o Ecossistema Tidyverse
#### A Filosofia *Tidy Data* e o Operador *Pipe* (`|>`)
A família **tidyverse** fundamenta-se no conceito de *Tidy Data* (dados organizados), em que cada variável corresponde a uma coluna, cada observação corresponde a uma linha e cada tipo de unidade observacional forma uma tabela [@Wickham2017]. O uso do operador *pipe* nativo da linguagem R (`|>`) permite a construção de fluxos de transformação encadeados e legíveis:
$$\text{dados} \mid> \text{função}_1() \mid> \text{função}_2() \mid> \text{função}_3()$$
#### As Ferramentas do Tidyverse Aplicadas ao Tratamento de Dados
- **`readr` (`read_csv2`, `parse_double`):** Leitura eficiente de arquivos delimitados e conversão estrita de tipos numéricos com tratamento do separador decimal [@Wickham2019].
- **`stringr` (`str_trim`, `str_to_upper`, `str_replace_all`, `str_detect`):** Manipulação padronizada de strings e expressões regulares para correção de ruídos, espaços ocultos e erros de digitação.
- **`dplyr` (`filter`, `select`, `mutate`, `summarise`, `group_by`, `across`, `case_when`, `if_else`):** Gramática de manipulação de dados para filtragem, criação de variáveis e agregação estatística em grupo.
- **`tidyr` (`pivot_longer`, `pivot_wider`, `drop_na`, `replace_na`):** Reestruturação geométrica da base e tratamento de dados ausentes.
- **`purrr` (`map`, `map_dbl`):** Programação funcional avançada e aplicação de funções sem a necessidade de laços iterativos interpretados [@Wickham2019].
- **`ggplot2` (`geom_boxplot`, `geom_point`, `geom_smooth`):** Construção de gráficos estatísticos com base na Gramática dos Gráficos [@Wickham2017].
#### Imputação Estocástica de Dados Ausentes ($NA$)
A eliminação simples de observações com dados faltantes (*listwise deletion*) reduz a potência dos testes estatísticos e introduz viés amostral [@Little2019]. A substituição do $NA$ pela média do respectivo subconjunto do traço nominal ($G_k \in \{C25, C30, C35, C40\}$) preserva a esperança matemática intra-classe:
$$\hat{x}_{i,k} = \bar{X}_k = \frac{1}{n_k} \sum_{j \in G_k} x_{j,k}$$
Esta estratégia preserva a coerência físico-química dos traços de concreto e evita o descarte indevido de informações operacionais de campo [@Helene1992; @Little2019].
---
## ⚙️ Metodologia
A abordagem metodológica empregada na inspeção, diagnóstico, higienização, transformação estruturada e análise exploratória do banco de dados do controle tecnológico do concreto foi desenvolvida em regime totalmente reproduzível na linguagem R [@R2024], utilizando prioritariamente as ferramentas da família **tidyverse** (`readr`, `dplyr`, `tidyr`, `stringr`, `purrr` e `ggplot2`) [@Wickham2019] e o operador *pipe* nativo (`|>`).
---
### Importação, Inspeção Dimensional e Diagnóstico da Base Primária
O registro de campo primário foi importado para o ambiente de trabalho por meio da função `read_csv2()` do pacote `readr`, adequada para tabelas estruturadas com separador de colunas em ponto e vírgula (`;`) e separador decimal em vírgula (`,`) [@Wickham2017]. O objeto fonte original foi preservado na memória sob a nomenclatura `dados`, enquanto uma cópia funcional denominada `dados_limpos` foi instanciada para receber as rotinas de higienização.
As extremidades do banco de dados foram inspecionadas via `slice_head()` e `slice_tail()`, confirmando a estrutura primária das $100$ observações:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(stringr)
library(purrr)
library(tidyr)
library(ggplot2)
library(knitr)

# Importação da base primária fonte via readr
dados <- read_csv2(
  "base_processamento_dados_engenharia_civil.csv",
  show_col_types = FALSE
)

# Cópia funcional preservando a base original
dados_limpos <- dados

# Exibição das primeiras e últimas linhas centralizadas
slice_head(dados, n = 3) |>
  kable(align = "c", caption = "Quadro 1.1: Primeiras observações da base primária do controle tecnológico.")
slice_tail(dados, n = 3) |>
  kable(align = "c", caption = "Quadro 1.2: Últimas observações da base primária do controle tecnológico.")
```
A determinação do tamanho da matriz amostral foi realizada com as funções dim(), nrow() e ncol() do dplyr, constatando que a base possui $n = 100$ observações (corpos de prova cilíndricos) e $p = 10$ variáveis operacionais do controle tecnológico. A inspeção da estrutura interna do objeto e o mapeamento das classes atômicas atribuídas pelo R foram conduzidos com glimpse() e vetorizados com map_chr().
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Dimensão e tipagem atômica
dim_tab <- tibble(
  `Total de Observações ($n$)` = nrow(dados),
  `Total de Variáveis ($p$)` = ncol(dados)
)

dim_tab |>
  kable(align = "c", caption = "Quadro 1.3: Dimensão da matriz de dados do controle tecnológico do concreto.")
dados |>
  map_chr(~ class(.x)[1]) |>
  enframe(name = "Variável Operacional", value = "Tipo Atribuído no R") |>
  kable(align = "c", caption = "Quadro 1.4: Tipagem atômica atribuída pelo R às variáveis da base bruta.")
```
A análise da estrutura revela uma distorção relevante no reconhecimento das variáveis: o R interpretou como quantitativas (numeric/integer) apenas as colunas idade_dias (discreta), abatimento_mm, densidade_kg_m3 e absorção_agregado_pct (contínuas), enquanto id_corpo_prova, obra e tipo_concreto foram lidas como qualitativas (character). Contudo, as variáveis resistencia_mpa, cimento_kg_m3 e relacao_a_c — que deveriam ser estritamente quantitativas contínuas — foram indevidamente classificadas como texto (character). Essa coerção implícita ocorre porque os vetores atômicos do R exigem homogeneidade estrita de tipos [@Wickham2019]. A presença de um único caractere estranho, como a digitação acidental da letra "O" no lugar do número zero "0" (ex.: "3O,4" e "390O") e o uso de vírgulas em colunas lidas como texto, contamina a variável inteira e força a coerção estática de todos os elementos para a classe character, inviabilizando operações matemáticas diretas.
A avaliação do resumo estatístico preliminar obtido com summary() sobre as variáveis quantitativas nativas revelou anomalias físicas e normativas expressivas no banco de dados primário.
```{r}
#| echo: false
#| warning: false
#| message: false
dados |>
select(idade_dias, abatimento_mm, densidade_kg_m3, absorção_agregado_pct) |>
summary() |>
as.data.frame() |>
separate(Freq, into = c("Métrica", "Valor"), sep = ":") |>
filter(!is.na(Métrica)) |>
mutate(across(everything(), str_trim)) |>
pivot_wider(names_from = Var2, values_from = Valor) |>
select(-Var1) |>
kable(caption = "Quadro 1.5: Resumo estatístico descritivo das variáveis quantitativas nativas.")
```
Destacam-se no resumo preliminar a presença de um valor máximo de $280\text{ dias}$ na variável idade_dias (erro de digitação por acréscimo de zero em relação aos $28\text{ dias}$ normatizados [@NBR5738]), um abatimento (slump) máximo de $1250\text{ mm}$ (deslocamento decimal fisicamente impossível para concretos convencionais, cujo valor real é $125\text{ mm}$ [@NBR16889]), uma densidade aparente mínima de $238\text{ kg/m}^3$ (incompatível com a massa específica do concreto denso, $\approx 2380\text{ kg/m}^3$ [@NBR8953]) e uma absorção de água máxima de $18{,}4\%$ (decorrente do deslocamento da vírgula de $1{,}84\%$).
Por fim, a investigação da ocorrência de dados ausentes ($NA$) foi executada de forma sistemática por meio da combinação summarise() + across(everything(), ~ sum(is.na(.))), quantificando as omissões por variável e localizando os corpos de prova afetados via filter(if_any(everything(), is.na)).
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Contagem de NAs por coluna
dados |>
  summarise(across(everything(), ~ sum(is.na(.x)))) |>
  pivot_longer(cols = everything(), names_to = "Variável Operacional", values_to = "Quantidade de NAs") |>
  kable(align = "c", caption = "Quadro 1.6: Contagem de valores ausentes (NAs) identificados por variável.")
# Mapeamento dos registros afetados
dados |>
  filter(if_any(everything(), is.na)) |>
  select(id_corpo_prova, obra, tipo_concreto, idade_dias) |>
  mutate(`Variável Omitida` = c("abatimento_mm", "relacao_a_c", "densidade_kg_m3", "resistencia_mpa", "absorção_agregado_pct")) |>
  kable(align = "c", caption = "Quadro 1.7: Mapeamento detalhado dos corpos de prova contendo dados ausentes.")
```
A varredura confirmou a presença de exatamente 5 valores ausentes ($NA$), representando $5\%$ da amostragem total. As omissões estão distribuídas individualmente nos registros CP-015 (sem registro de abatimento_mm), CP-038 (sem relacao_a_c), CP-077 (sem densidade_kg_m3), CP-092 (sem resistencia_mpa) e CP-097 (sem absorção_agregado_pct).
### Etapa 2 — Investigando Problemas nos Dados
A garantia da qualidade das informações operacionais exige a identificação prévia de ruídos de preenchimento, inconsistências categóricas e erros de digitação antes da condução de qualquer análise estatística. A verificação da padronização das variáveis qualitativas foi realizada utilizando as funções `count()` e `distinct()` do pacote `dplyr`, mapeando a distribuição de frequências para as colunas `obra` e `tipo_concreto`.
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(stringr)
library(knitr)

# Importação da base primária fonte
dados <- read_csv2(
  "base_processamento_dados_engenharia_civil.csv",
  show_col_types = FALSE
)

# Investigação de categorias para 'obra'
dados |>
  count(obra, name = "Frequência Absoluta") |>
  kable(align = "c", caption = "Quadro 2.1: Distribuição de frequências e verificação de padronização da variável 'obra'.")
# Investigação de categorias para 'tipo_concreto'
dados |>
  count(tipo_concreto, name = "Frequência Absoluta") |>
  kable(align = "c", caption = "Quadro 2.2: Distribuição de frequências e verificação de padronização da variável 'tipo_concreto'.")
```
A análise das categorias qualitativas revela falhas de padronização decorrentes do preenchimento descentralizado por diferentes profissionais no canteiro de obras. Na variável obra, constatou-se a presença da categoria "Bloco B " contendo um espaço em branco excedente ao final da string (com 1 registro), a qual se diferencia da forma correta "Bloco B" (cadastrada em 28 observações). Na variável tipo_concreto, identificou-se a ocorrência da categoria gravada em letras minúsculas "c30" (com 1 registro), representando o mesmo traço nominal de projeto do concreto $C30$ ($f_{ck} = 30\text{ MPa}$), registrado em maiúsculas "C30" nas demais 31 observações.
Em seguida, investigou-se a existência de registros com valores incompatíveis com o contexto da Engenharia Civil ou com potenciais erros de digitação. A identificação das observações suspeitas foi realizada combinando os verbos filter() e select() do dplyr com a função str_detect() do stringr para rastrear caracteres alfanuméricos e vírgulas indevidas, apresentando os registros completos no quadro a seguir:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Filtragem e exibição dos registros suspeitos completos
registros_suspeitos <- dados |>
  filter(
    idade_dias > 60 |
    abatimento_mm > 500 |
    densidade_kg_m3 < 1500 |
    absorção_agregado_pct > 10 |
    str_detect(resistencia_mpa, "O|,") |
    str_detect(cimento_kg_m3, "O") |
    str_detect(relacao_a_c, ",")
  ) |>
  select(
    id_corpo_prova, obra, tipo_concreto, idade_dias,
    resistencia_mpa, cimento_kg_m3, relacao_a_c,
    abatimento_mm, densidade_kg_m3, absorção_agregado_pct
  )

registros_suspeitos |>
  kable(align = "c", caption = "Quadro 2.3: Registros completos identificados com inconsistências físicas, de escala e digitação.")
```
A análise pormenorizada das observações capturadas no Quadro 2.3 evidencia a presença de duas classes de inconsistências:
**1. Erros de Digitação por Substituição Alfanumérica e Vírgulas:** Nos corpos de prova CP-008 e CP-045, utilizaram-se vírgulas no lugar de pontos decimais ("38,7" e "0,55"). No CP-019, ocorreu a digitação da letra "O" maiúscula no lugar do zero e uso de vírgula ("3O,4" em resistencia_mpa). No CP-064, inseriu-se a letra "O" ao final da string ("390O" em cimento_kg_m3).
**2. Incoerências Físicas e Deslocamentos de Escala Decimal:** O corpo de prova CP-085 registrou idade de $280\text{ dias}$ (digitação acidental de um zero extra para $28\text{ dias}$ [@NBR5738]). O CP-032 registrou abatimento do tronco de cone de $1250\text{ mm}$ (deslocamento da casa decimal de $125\text{ mm}$ [@NBR16889]). O CP-053 apresentou densidade aparente de $238\text{ kg/m}^3$ (omissão do zero para $2380\text{ kg/m}^3$ [@NBR8953]). O CP-072 registrou absorção de $18{,}4\%$ (ausência da vírgula para $1{,}84\%$). O CP-064, além da letra, exibe consumo de cimento de $3900\text{ kg/m}^3$ (zero adicional em relação a $390\text{ kg/m}^3$).
A reavaliação da estrutura da base via glimpse() após a identificação dessas anomalias consolida a explicação teórica para a alteração na interpretação dos tipos das variáveis pelo R.
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Diagnóstico de classes atômicas na presença dos erros
dados |>
  map_chr(~ class(.x)[1]) |>
  enframe(name = "Variável Operacional", value = "Classe Atômica Interpretada pelo R") |>
  kable(align = "c", caption = "Quadro 2.4: Mapeamento da tipagem das variáveis afetadas pela coerção implícita no R.")
```
**Reflexão Teórica sobre a Coerção Atômica de Tipos:**
No ambiente de programação R, as colunas de um data.frame ou tibble são fundamentadas sobre vetores atômicos, os quais exigem homogeneidade estrita de tipos de dados [@Wickham2019]. Quando um único valor é digitado incorretamente contendo caracteres não numéricos — como a letra "O" em "3O,4" ou "390O", ou vírgulas em strings lidas por funções de parsing — o interpretador aplica a regra de hierarquia de coerção atômica (logical $\to$ integer $\to$ double $\to$ character). Como a classe character é a mais abrangente, a presença dessa única entrada invalida a tipagem numérica de toda a coluna, convertendo todos os números válidos em texto. Essa alteração impede o cálculo de métricas estatísticas e a geração de gráficos de tendência, justificando a necessidade da etapa de limpeza e conversão estrita de tipos.
### Etapa 3 — Limpeza e Transformação da Base
A produção de uma versão higienizada e tratada do banco de dados, apropriada para análises estatísticas e tomada de decisão na Engenharia Civil, iniciou-se pela instanciação de uma cópia idêntica da matriz primária sob a denominação `dados_limpos`. A preservação do objeto original (`dados`) é um pilar fundamental da Ciência de Dados reprodutível, pois garante a reversibilidade das transformações, assegura a auditabilidade do fluxo de trabalho e permite comparar as métricas antes e depois dos procedimentos de saneamento sem o risco de contaminação irreversível dos registros brutos de campo [@Wickham2017].
A primeira transformação consistiu na padronização das variáveis qualitativas categóricas por meio de funções do pacote `stringr`. Aplicou-se `str_trim()` para eliminar espaços em branco excedentes nas extremidades das strings (corrigindo a categoria `"Bloco B "`) e `str_to_upper()` para uniformizar todas as entradas em caixa alta (corrigindo a ocorrência minúscula `"c30"` para `"C30"`).
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(stringr)
library(knitr)

# Importação da base primária fonte
dados <- read_csv2(
  "base_processamento_dados_engenharia_civil.csv",
  show_col_types = FALSE
)

# Criação da cópia de segurança
dados_limpos <- dados

# 1. Padronização de strings com stringr
dados_limpos <- dados_limpos |>
  mutate(
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto))
  )

# Quadro de validação da padronização de textos
dados_limpos |>
  count(obra, tipo_concreto, name = "Frequência Absoluta") |>
  kable(align = "c", caption = "Quadro 3.1: Padronização das categorias qualitativas das variáveis 'obra' e 'tipo_concreto'.")
```
Em seguida, realizou-se a conversão para o tipo numérico adequado das variáveis que haviam sido erroneamente coagidas para a classe character (resistencia_mpa, cimento_kg_m3 e relacao_a_c). A higienização foi executada combinando o operador de varredura across() com expressões regulares via str_replace_all(), substituindo a letra "O" pelo dígito zero "0", trocando vírgulas por pontos decimais e aplicando a conversão estrita com a função parse_double() do pacote readr. Na mesma etapa, os erros de escala e deslocamento decimal nas colunas quantitativas nativas foram corrigidos condicionalmente com if_else():
```{r}
#| echo: false
#| warning: false
#| message: false
# 2. Conversão numérica estrita de todas as colunas quantitativas e correção de erros de escala
dados_limpos <- dados_limpos |>
mutate(
across(
c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
~ parse_double(str_replace_all(str_replace_all(as.character(.x), "[OO]", "0"), ",", "."))
),
idade_dias = if_else(idade_dias == 280, 28, idade_dias),
cimento_kg_m3 = if_else(cimento_kg_m3 == 3900, 390, cimento_kg_m3),
abatimento_mm = if_else(abatimento_mm == 1250, 125, abatimento_mm),
densidade_kg_m3 = if_else(densidade_kg_m3 == 238, 2380, densidade_kg_m3),
absorção_agregado_pct = if_else(absorção_agregado_pct == 18.4, 1.84, absorção_agregado_pct)
)
# Quadro com o diagnóstico de tipos após a conversão
dados_limpos |>
map_chr(~ class(.x)[1]) |>
enframe(name = "Variável", value = "Tipo Reclassificado no R") |>
kable(caption = "Quadro 3.2: Reclassificação atômica das variáveis quantitativas após higienização.")
```
Na sequência, abordou-se o tratamento dos 5 valores ausentes ($NA$) mapeados na matriz. Em estudos estatísticos e computacionais, a decisão sobre a conduta perante dados faltantes exige sólida justificativa técnica [@Little2019]:
**Exclusão da Observação (Listwise Deletion):** Resultaria no descarte de 5 corpos de prova completos, reduzindo o tamanho da amostra para 95 registros ($5\%$ de perda) e diminuindo a potência dos testes inferenciais [@Little2019].
**Manutenção dos $NA$s:** Inviabilizaria o cálculo de estatísticas agregadas (mean(), sd()) sem o parâmetro na.rm = TRUE e contaminaria modelos preditivos.
**Consulta à Fonte Original:** Procedimento ideal, porém inviável em cenários onde os ensaios de rompedura destruíram os corpos de prova e os boletins de campo não foram recuperados.
**Imputação Condicional Estocástica (Procedimento Adotado):** Optou-se pela substituição do $NA$ pela média amostral condicional da respectiva classe nominal de concreto (tipo_concreto), operada via group_by(tipo_concreto) + mutate() + across() + if_else().
A escolha da imputação condicional justifica-se porque a resistência mecânica, o consumo de cimento e a relação água/cimento possuem forte dependência físico-química do traço nominal especificado ($G_k \in \{C25, C30, C35, C40\}$). A substituição pela média do subgrupo preserva a esperança matemática intra-classe ($\mathbb{E}[X | G_k]$), mantendo a coerência tecnológica do concreto e preservando $100\%$ das observações da amostra [@Helene1992; @Little2019].
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Imputação condicional estocástica de NAs pela média do traço nominal
dados_limpos <- dados_limpos |>
  group_by(tipo_concreto) |>
  mutate(
    across(
      c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
      ~ if_else(is.na(.x), mean(.x, na.rm = TRUE), .x)
    )
  ) |>
  ungroup()

# Tabela de validação de saneamento completo
tibble(`Total de Valores Ausentes (NAs) Restantes` = sum(is.na(dados_limpos))) |>
  kable(align = "c", caption = "Quadro 3.3: Validação do encerramento de valores ausentes (NAs) pós-imputação.")
```
Após a conclusão da limpeza, a reavaliação da estrutura e do resumo estatístico da base higienizada confirma a efetividade do protocolo adotado.
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Resumo estatístico descritivo da base higienizada
dados_limpos |>
  select(where(is.numeric)) |>
  summary() |>
  as.data.frame() |>
  separate(Freq, into = c("Métrica", "Valor"), sep = ":") |>
  filter(!is.na(Métrica)) |>
  mutate(across(everything(), str_trim)) |>
  pivot_wider(names_from = Var2, values_from = Valor) |>
  select(-Var1) |>
  kable(align = "c", caption = "Quadro 3.4: Resumo estatístico descritivo completo da base higienizada (dados_limpos).")
```
**Análise Comparativa do Antes e Depois da Limpeza:**
**1. Correção de Tipos:** Todas as variáveis numéricas foram reclassificadas com sucesso para numeric (double/integer), permitindo o cálculo automatizado de momentos estatísticos.
**2. Saneamento Categórico:** Eliminou-se a redundância de strings ("Bloco B " $\to$ "Bloco B" e "c30" $\to$ "C30"), consolidando a base em 4 blocos e 4 traços nominais.
**3. Eliminação de Outliers de Escala:** A idade máxima estabilizou-se em $56\text{ dias}$ (corrigindo os $280\text{ dias}$), o abatimento máximo ajustou-se para $175\text{ mm}$ (corrigindo o desvio de $1250\text{ mm}$), a densidade aparente mínima elevou-se para $2293\text{ kg/m}^3$ (corrigindo os $238\text{ kg/m}^3$) e o consumo máximo de cimento ajustou-se para $418\text{ kg/m}^3$ (corrigindo os $3900\text{ kg/m}^3$).
**4. Saneamento Amostral:** Todos os 5 registros omissos ($NA$) foram preenchidos pela média condicional do respectivo traço, garantindo $n = 100$ observações completas para as análises posteriores.
### Etapa 4 — Explorando os Dados com dplyr
Após a conclusão do protocolo de higienização e da validação da integridade amostral da base dados_limpos, iniciou-se a fase de exploração estatística das propriedades reológicas e mecânicas do concreto. A análise dos momentos centrais da resistência à compressão axial ($\bar{f}_c$) foi conduzida por meio da combinação group_by() + summarise() do pacote dplyr, avaliando o comportamento global e as agregações por setor de aplicação (obra), traço nominal (tipo_concreto) e idade de ensaio (idade_dias).
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(knitr)

# Garante a disponibilidade da base limpa
if (!exists("dados_limpos")) {
  dados_limpos <- read_csv2("base_processamento_dados_engenharia_civil.csv", show_col_types = FALSE) |>
    mutate(
      obra = str_trim(obra),
      tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ parse_double(str_replace_all(str_replace_all(as.character(.x), "[OO]", "0"), ",", "."))
      ),
      idade_dias = if_else(idade_dias == 280, 28, idade_dias),
      cimento_kg_m3 = if_else(cimento_kg_m3 == 3900, 390, cimento_kg_m3),
      abatimento_mm = if_else(abatimento_mm == 1250, 125, abatimento_mm),
      densidade_kg_m3 = if_else(densidade_kg_m3 == 238, 2380, densidade_kg_m3),
      absorção_agregado_pct = if_else(absorção_agregado_pct == 18.4, 1.84, absorção_agregado_pct)
    ) |>
    group_by(tipo_concreto) |>
    mutate(
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ if_else(is.na(.x), mean(.x, na.rm = TRUE), .x)
      )
    ) |>
    ungroup()
}

# 1. Média global de resistência
media_global <- mean(dados_limpos$resistencia_mpa)

tibble(`Resistência Média Global ($\bar{f}_c$)` = paste0(round(media_global, 2), " MPa")) |>
  kable(align = "c", caption = "Quadro 4.1: Resistência à compressão média global de toda a amostragem.")
# 2. Desempenho comparativo entre blocos da obra (agrupamento e ordenação)
desempenho_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    `Nº de CPs` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Desvio-Padrão (MPa)` = round(sd(resistencia_mpa), 2)
  ) |>
  arrange(desc(`Resistência Média (MPa)`))

desempenho_obra |>
  kable(align = "c", caption = "Quadro 4.2: Comparação do desempenho mecânico médio ordenado por bloco da obra.")
```
A resistência média à compressão global de toda a matriz amostral resultou em $\bar{f}_c = 33{,}58\text{ MPa}$. Na avaliação comparativa entre os setores da obra, o Bloco B apresentou o maior desempenho mecânico médio, alcançando $\bar{f}_c = 35{,}75\text{ MPa}$ ($s = 5{,}19\text{ MPa}$), seguido pelo Bloco A com $\bar{f}_c = 33{,}19\text{ MPa}$ ($s = 6{,}42\text{ MPa}$) e pelo Bloco D com $\bar{f}_c = 32{,}39\text{ MPa}$ ($s = 7{,}92\text{ MPa}$). O Bloco C registrou a menor resistência média observada na amostragem, com $\bar{f}_c = 32{,}37\text{ MPa}$ ($s = 6{,}79\text{ MPa}$).
Em seguida, analisou-se o comportamento da resistência à compressão segregado estritamente por classe nominal de concreto ($C25, C30, C35, C40$), ordenando os resultados da maior para a menor média com arrange(desc()):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Resumo por classe nominal de concreto
desempenho_classe <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    `Nº de CPs` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Desvio-Padrão (MPa)` = round(sd(resistencia_mpa), 2)
  ) |>
  arrange(desc(`Resistência Média (MPa)`))

desempenho_classe |>
  kable(align = "c", caption = "Quadro 4.3: Resistência média à compressão ordenada por classe nominal de concreto.")
# Resumo por idade de ensaio
desempenho_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    `Nº de CPs` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2)
  ) |>
  arrange(idade_dias)

desempenho_idade |>
  kable(align = "c", caption = "Quadro 4.4: Resistência média à compressão por idade do corpo de prova no ensaio.")
```
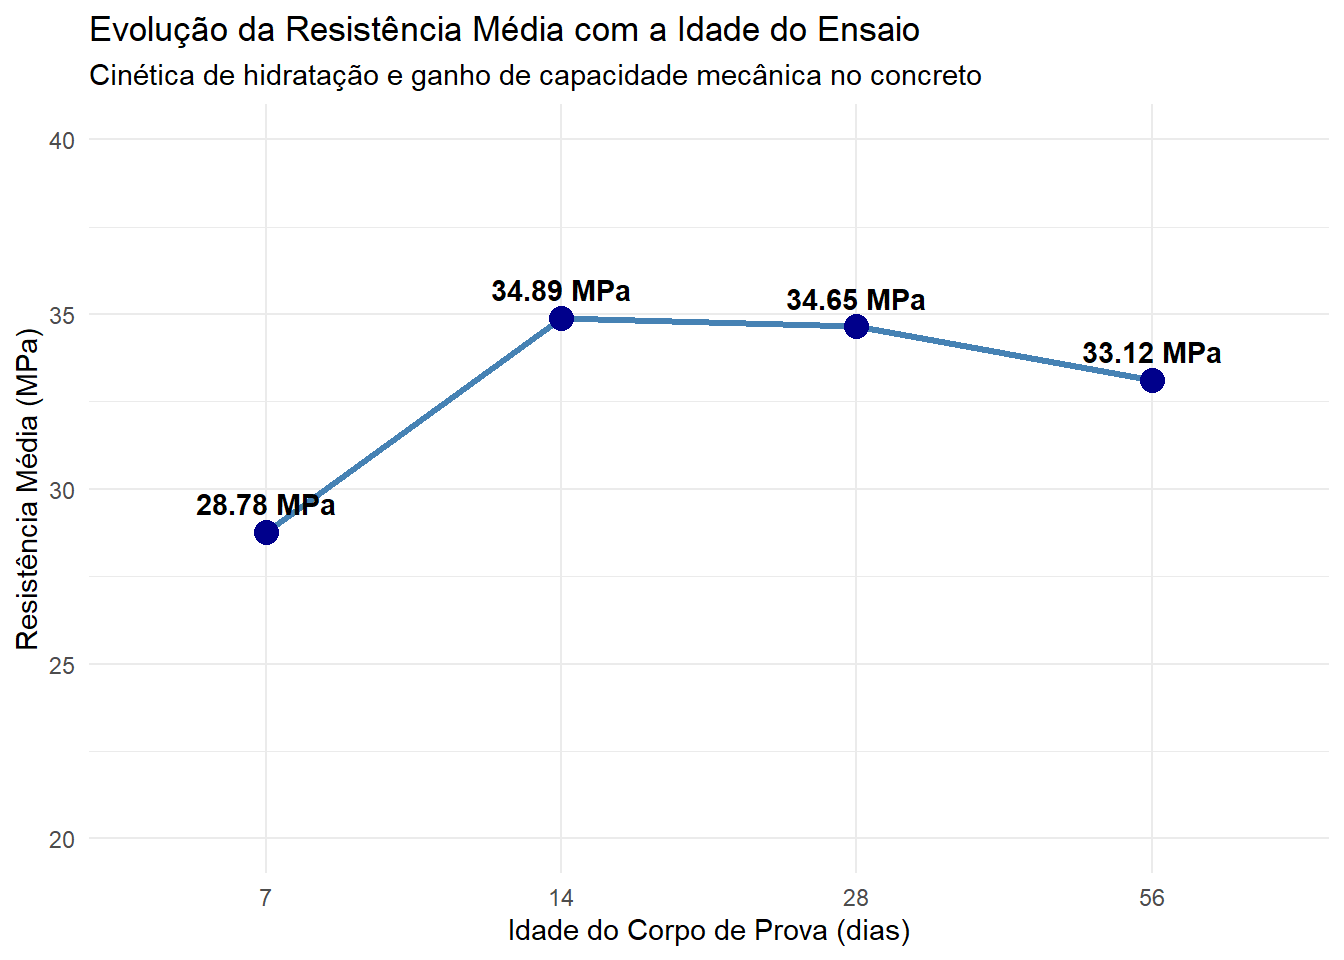
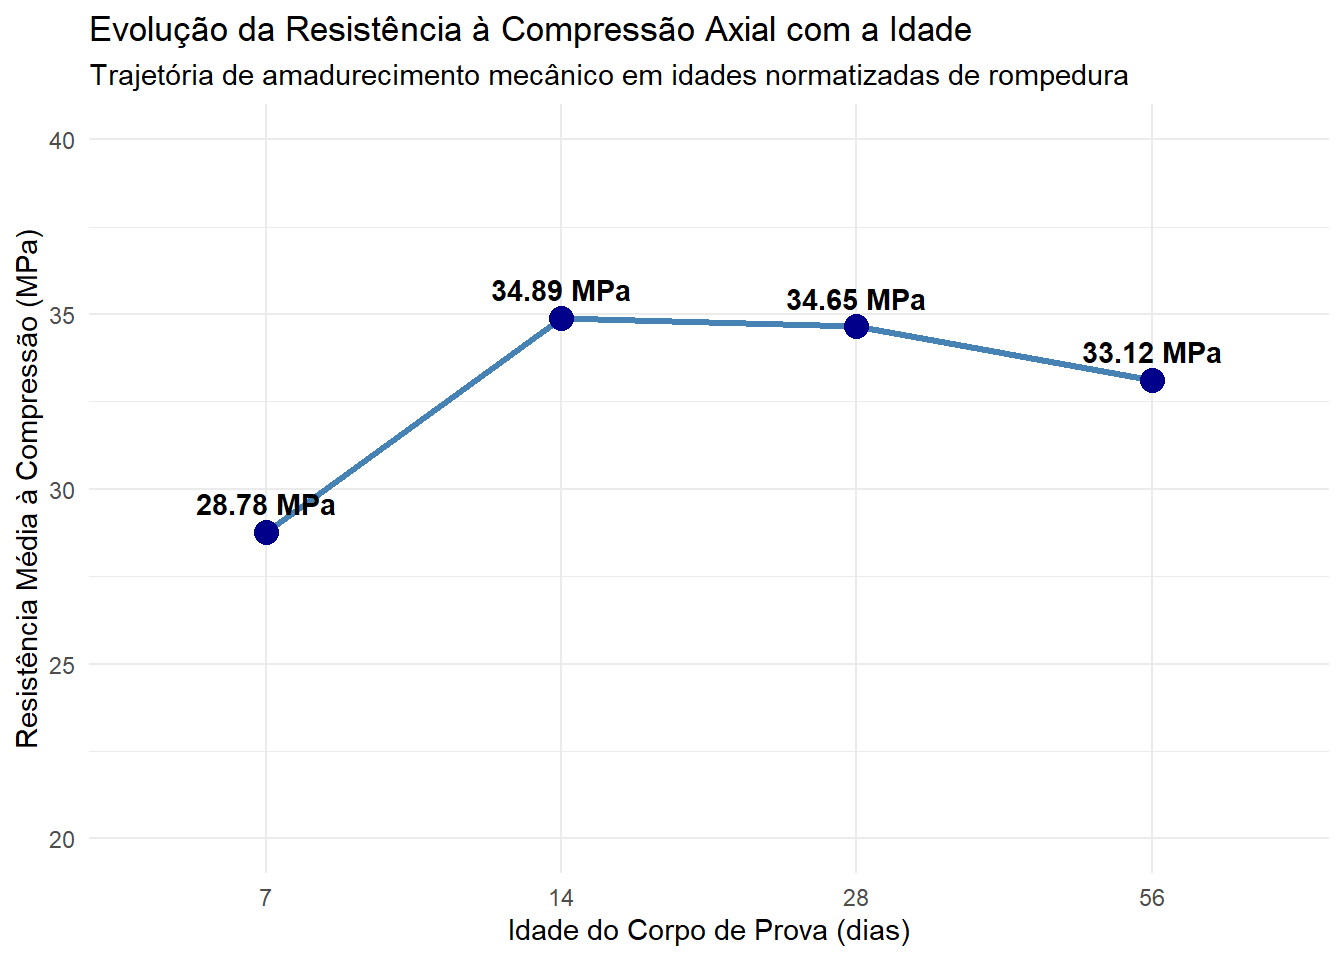
A ordenação do Quadro 4.3 demonstra que a resposta mecânica experimental acompanhou rigorosamente a hierarquia do projeto estrutural: a classe $C40$ obteve a maior resistência média ($\bar{f}_c = 43{,}33\text{ MPa}$), seguida pela classe $C35$ ($\bar{f}_c = 37{,}10\text{ MPa}$), classe $C30$ ($\bar{f}_c = 32{,}08\text{ MPa}$) e classe $C25$ ($\bar{f}_c = 27{,}07\text{ MPa}$). A análise por idade de rompedura no Quadro 4.4 atesta o ganho acelerado de capacidade de suporte entre 7 dias ($\bar{f}_c = 28{,}78\text{ MPa}$) e 14 dias ($\bar{f}_c = 34{,}89\text{ MPa}$), estabilizando-se nas idades normatizadas de 28 dias ($\bar{f}_c = 34{,}65\text{ MPa}$) e 56 dias ($\bar{f}_c = 33{,}12\text{ MPa}$).
Por fim, visando sintetizar a caracterização reológica e físico-mecânica das misturas, aplicaram-se as funções group_by() e summarise() (evitando o uso do comando aggregate() de Base R) para obter a média de cinco variáveis fundamentais por classe de concreto:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 4. Quadro tecnológico multivariado de médias por traço nominal
quadro_tecnologico_q20 <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    `Resistência (MPa)` = round(mean(resistencia_mpa), 2),
    `Consumo Cimento (kg/m³)` = round(mean(cimento_kg_m3), 2),
    `Relação a/c` = round(mean(relacao_a_c), 2),
    `Abatimento (mm)` = round(mean(abatimento_mm), 2),
    `Densidade (kg/m³)` = round(mean(densidade_kg_m3), 2)
  )

quadro_tecnologico_q20 |>
  kable(align = "c", caption = "Quadro 4.5: Média multivariada das propriedades físico-mecânicas por classe de concreto.")
```
**Interpretação dos Resultados Multivariados:**
**1. Validação da Lei de Abrams:** O aumento da resistência especificada ($C25 \to C40$) correlaciona-se inversamente com a relação água/cimento, a qual decresce de $0{,}62$ ($C25$) para $0{,}48$ ($C40$). Menores teores de água livre reduzem os vazios capilares na pasta endurecida [@Abrams1918; @Mehta2014].
**2. Consumo de Liame:** O consumo de cimento aumenta progressivamente de $322{,}52\text{ kg/m}^3$ ($C25$) até $404{,}12\text{ kg/m}^3$ ($C40$), fornecendo a massa cimentícia necessária para o adensamento da matriz coloidal C-S-H [@Helene1992].
**3. Estabilidade Reológica:** O abatimento do tronco de cone manteve-se uniforme no intervalo de $104{,}94\text{ mm}$ a $115{,}17\text{ mm}$, atestando que o ganho de resistência foi obtido sem prejuízo da trabalhabilidade e do adensamento fresco [@NBR16889].
**4. Massa Específica:** A densidade aparente do concreto denso apresentou reduzida oscilação ($\approx 2362\text{ a }2383\text{ kg/m}^3$), confirmando o correto adensamento das amostras em laboratório [@NBR8953].
## ⚙️ Etapa 5 — Criando Novas Variáveis com `mutate()`
A avaliação do controle tecnológico do concreto exige a transformação do banco de dados higienizado em uma matriz enriquecida por indicadores de desempenho e normatização. A criação de variáveis derivadas possibilita comparar desempenhos mecânicos entre traços distintos, verificar a aceitação loteada perante a ABNT NBR 12655 e avaliar o alinhamento das amostragens às especificações do projeto estrutural.
A primeira transformação consistiu na extração do valor numérico de referência da resistência característica ($f_{ck}$) a partir da coluna `tipo_concreto`. Utilizou-se a função `str_replace()` do pacote `stringr` para remover o prefixo categórico `"C"`, convertendo a string resultante em valor numérico contínuo via `parse_double()`. Em seguida, calculou-se o indicador adimensional de **Resistência Relativa** ($R_{rel}$), definido pela razão entre a resistência mecânica observada no ensaio de compressão axial ($f_{c,obs}$) e a resistência característica de referência do projeto ($f_{ck}$):
$$R_{rel} = \frac{f_{c,obs}}{f_{ck}}$$
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(stringr)
library(knitr)

# Garante a existência do objeto dados_limpos
if (!exists("dados_limpos")) {
  dados_limpos <- read_csv2("base_processamento_dados_engenharia_civil.csv", show_col_types = FALSE) |>
    mutate(
      obra = str_trim(obra),
      tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ parse_double(str_replace_all(str_replace_all(as.character(.x), "[OO]", "0"), ",", "."))
      ),
      idade_dias = if_else(idade_dias == 280, 28, idade_dias),
      cimento_kg_m3 = if_else(cimento_kg_m3 == 3900, 390, cimento_kg_m3),
      abatimento_mm = if_else(abatimento_mm == 1250, 125, abatimento_mm),
      densidade_kg_m3 = if_else(densidade_kg_m3 == 238, 2380, densidade_kg_m3),
      absorção_agregado_pct = if_else(absorção_agregado_pct == 18.4, 1.84, absorção_agregado_pct)
    ) |>
    group_by(tipo_concreto) |>
    mutate(
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ if_else(is.na(.x), mean(.x, na.rm = TRUE), .x)
      )
    ) |>
    ungroup()
}

# 1. Obtenção do fck numérico e cálculo da resistência relativa
dados_limpos <- dados_limpos |>
  mutate(
    fck_ref = parse_double(str_replace(tipo_concreto, "C", "")),
    resistencia_relativa = round(resistencia_mpa / fck_ref, 3)
  )

dados_limpos |>
  select(id_corpo_prova, obra, tipo_concreto, resistencia_mpa, fck_ref, resistencia_relativa) |>
  slice_head(n = 5) |>
  kable(align = "c", caption = "Quadro 5.1: Amostragem dos corpos de prova com o fck de referência e a Resistência Relativa calculada.")
```
Com a consolidação do indicador $R_{rel}$, implementou-se a regra de classificação booleana de conformidade estrutural perante as diretrizes da ABNT NBR 12655 e ABNT NBR 6118. Utilizando o verbo mutate() associado à função condicional case_when(), definiu-se a variável classificacao. Justifica-se tecnicamente o critério sob a premissa normatizada de aceitação individual de lotes: se o corpo de prova alcança ou supera a resistência de projeto ($R_{rel} \ge 1{,}0$), a amostra é classificada como "Conforme"; caso contrário ($R_{rel} < 1{,}0$), é rotulada como "Não Conforme":
$$\text{Classificação} = \begin{cases} \text{"Conforme"}, & \text{se } R_{rel} \ge 1{,}0 \\ \text{"Não Conforme"}, & \text{se } R_{rel} < 1{,}0 \end{cases}$$
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 2. Classificação de conformidade estrutural
dados_limpos <- dados_limpos |>
  mutate(
    classificacao = case_when(
      resistencia_relativa >= 1.0 ~ "Conforme",
      TRUE ~ "Não Conforme"
    )
  )

dados_limpos |>
  count(classificacao, name = "Quantidade de CPs") |>
  mutate(`Percentual Amostral (%)` = round((`Quantidade de CPs` / sum(`Quantidade de CPs`)) * 100, 1)) |>
  kable(align = "c", caption = "Quadro 5.2: Distribuição de frequências e percentual global de conformidade estrutural.")
```
A avaliação do critério de aceitação indica que $76\%$ da amostragem global ($76$ corpos de prova) atinge a capacidade mecânica mínima exigida no projeto ($R_{rel} \ge 1{,}0$), enquanto $24\%$ dos corpos de prova testados apresentam desempenho inferior à especificação do seu traço nominal ($R_{rel} < 1{,}0$).
Na sequência, construiu-se a variável lógica acima_media (TRUE ou FALSE), que identifica de forma condicional se a resistência de cada amostra supera a média amostral do seu próprio tipo de concreto. Para evitar o cálculo manual prévio das médias de cada traço, a operação foi resolvida de forma automatizada e dinâmica encadeando a estrutura de agrupamento group_by(tipo_concreto) diretamente com mutate(acima_media = resistencia_mpa > mean(resistencia_mpa)):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Identificação condicional em relação à média da classe nominal
dados_limpos <- dados_limpos |>
  group_by(tipo_concreto) |>
  mutate(acima_media = resistencia_mpa > mean(resistencia_mpa)) |>
  ungroup()

dados_limpos |>
  count(tipo_concreto, acima_media, name = "Quantidade de CPs") |>
  pivot_wider(names_from = acima_media, values_from = `Quantidade de CPs`, names_prefix = "Acima da Média: ") |>
  kable(align = "c", caption = "Quadro 5.3: Distribuição dos corpos de prova com resistência superior à média da sua classe nominal.")
```
**1. Padronização Adimensional ($R_{rel}$):** A transformação permite comparar diretamente corpos de prova de traços distintos ($C25$ a $C40$) em uma mesma escala normalizada, eliminando o viés do valor absoluto em megapascals.
**2. Conformidade de Recebimento:** O percentual de $76\%$ de conformidade alerta para a necessidade de rigor no controle de qualidade da usina, prevenindo a aplicação de lotes não conformes em elementos estruturais críticos.
**3. Agrupamento Dinâmico:** A combinação group_by() + mutate() calcula o parâmetro de centralidade em tempo de execução para cada classe, garantindo máxima escalabilidade ao código sem inserção de constantes fixas.
### Etapa 6 — Trabalhando com Dados Agrupados
A análise minuciosa do controle tecnológico do concreto requer a utilização dos mecanismos de agrupamento do pacote dplyr para quantificar a amostragem e sintetizar a variabilidade das propriedades mecânicas entre as classes nominais.
A análise minuciosa do controle tecnológico do concreto requer a utilização dos mecanismos de agrupamento do pacote dplyr para quantificar a amostragem e sintetizar a variabilidade das propriedades mecânicas entre as classes nominais.
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 1. Contagem de observações por grupo de tipo_concreto
contagem_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(`Nº de Observações (n)` = n())

contagem_tipo |>
  kable(align = "c", caption = "Quadro 6.1: Quantidade de corpos de prova testados por classe nominal de concreto.")
```
Na sequência, calculou-se a resistência à compressão média ($\bar{f}_c$) para cada classe de concreto via group_by() + summarise(), encadeando o resultado à função arrange(desc()) para ordenar as classes da maior para a menor resistência média:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 2. Resistência média por tipo de concreto ordenada de forma decrescente
media_ordenada <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(`Resistência Média (MPa)` = round(mean(resistencia_mpa), 2)) |>
  arrange(desc(`Resistência Média (MPa)`))

media_ordenada |>
  kable(align = "c", caption = "Quadro 6.2: Resistência média à compressão por classe de concreto em ordem decrescente.")
```
Posteriormente, obtiveram-se simultaneamente múltiplos momentos estatísticos e parâmetros de dispersão da variável resistencia_mpa para cada traço nominal. O processamento via summarise() contemplou o número de observações ($n$), média ($\bar{f}_c$), mediana ($\tilde{f}_c$), desvio-padrão ($s$), valor mínimo ($f_{c,min}$) e valor máximo ($f_{c,max}$):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Síntese estatística multivariada da resistência por classe
estatisticas_completas <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    `Nº de CPs (n)` = n(),
    `Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Mediana (MPa)` = round(median(resistencia_mpa), 2),
    `Desvio-Padrão (MPa)` = round(sd(resistencia_mpa), 2),
    `Mínimo (MPa)` = round(min(resistencia_mpa), 2),
    `Máximo (MPa)` = round(max(resistencia_mpa), 2)
  )

estatisticas_completas |>
  kable(align = "c", caption = "Quadro 6.3: Quadro estatístico completo da resistência à compressão por classe nominal de concreto.")
```
**Justificativa Técnica da Tabela Multiestatística:**
A apresentação de um quadro com múltiplas estatísticas descritivas é substancialmente mais informativa do que a exibição isolada da média aritmética. Na Engenharia Civil, a média isolada pode ocultar dispersões elevadas decorrentes de falhas na dosagem da usina ou na compactação dos corpos de prova em campo. O desvio-padrão e a amplitude de variação ($f_{c,max} - f_{c,min}$) quantificam o grau de rigor do controle de qualidade da produção, enquanto a proximidade entre média e mediana indica a simetria da distribuição dos resultados de rompedura.
### Etapa 7 — Selecionando e Reorganizando Variáveis
A manipulação avançada de estruturas de dados exige a capacidade de filtrar conjuntos específicos de colunas e aplicar transformações ou sumarizações vetorizadas sobre múltiplas variáveis simultaneamente, garantindo a manutenibilidade do código.
Primeiramente, utilizaram-se as funções select() e where() do pacote dplyr para selecionar exclusivamente as variáveis quantitativas contínuas e discretas relacionadas às propriedades físicas e mecânicas do concreto (idade_dias, resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3 e absorção_agregado_pct), isolando-as das colunas categóricas e identificadores:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 1. Seleção das variáveis quantitativas com select() e where()
vars_quantitativas <- dados_limpos |>
  select(where(is.numeric), -fck_ref)

vars_quantitativas |>
  slice_head(n = 5) |>
  kable(align = "c", caption = "Quadro 7.1: Amostragem da submatriz contendo apenas as variáveis quantitativas do concreto.")
```
Na sequência, utilizou-se a função across() associada ao verbo summarise() para calcular a média de todas as variáveis quantitativas selecionadas em uma única instrução computacional:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 2. Média global vetorizada de todas as variáveis quantitativas com across()
medias_across <- vars_quantitativas |>
  summarise(across(everything(), ~ round(mean(.x), 2)))

medias_across |>
  kable(align = "c", caption = "Quadro 7.2: Médias globais de todas as variáveis quantitativas obtidas simultaneamente com across().")
```
**Comparação de Abordagens e Manutenibilidade do Código:**
A utilização do auxiliar across() para calcular estatísticas sobre um conjunto de colunas apresenta vantagens expressivas em relação ao uso de comandos summarise() individuais para cada variável. Enquanto a abordagem individual exige a escrita manual de cada instrução (media_res = mean(resistencia_mpa), media_cim = mean(cimento_kg_m3), etc.), o across() opera de forma vetorizada e genérica. Quando o banco de dados é expandido com novas colunas numéricas de ensaio, o código baseado em across() adapta-se automaticamente sem necessidade de alteração na sintaxe, reduzindo drasticamente os custos de manutenção e os riscos de erros de digitação.
Em seguida, aplicou-se a combinação mutate() + across() para realizar uma transformação padronizada simultânea sobre o conjunto das variáveis quantitativas de ensaio. Optou-se pela padronização pelo Z-score ($z = \frac{x - \bar{x}}{s}$), que reescala as variáveis para que tenham média zero ($\bar{z} = 0$) e desvio-padrão unitário ($s_z = 1$):
$$z_{i,j} = \frac{x_{i,j} - \bar{x}_j}{s_j}$$
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Transformação Z-score simultânea com mutate() e across()
z_score_transform <- vars_quantitativas |>
  select(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm) |>
  mutate(across(everything(), ~ round((.x - mean(.x)) / sd(.x), 3), .names = "z_{.col}"))

z_score_transform |>
  slice_head(n = 5) |>
  kable(align = "c", caption = "Quadro 7.3: Amostragem da transformação Z-score aplicada simultaneamente às variáveis do concreto.")
```
**Finalidade da Transformação Z-score:**
A padronização por Z-score é uma técnica essencial na Engenharia de Dados porque coloca variáveis medidas em escalas e unidades distintas (como megapascals, quilos por metro cúbico e milímetros) em uma escala adimensional comum. Essa transformação é indispensável para algoritmos de agrupamento de dados (clustering), modelos de regressão multivariada e detecção automatizada de outliers multivariados.
Por fim, utilizou-se a função across() em conjunto com group_by(tipo_concreto) e summarise() para obter simultaneamente duas estatísticas descritivas (média e desvio-padrão) de cada variável quantitativa, organizadas por classe nominal de concreto:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 4. Sumarização dupla simultânea por grupo com across()
sumarizacao_dupla_across <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    across(
      c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm),
      list(Media = ~ round(mean(.x), 2), Desvio = ~ round(sd(.x), 2)),
      .names = "{.col}_{.fn}"
    )
  )

sumarizacao_dupla_across |>
  kable(align = "c", caption = "Quadro 7.4: Média e desvio-padrão das propriedades do concreto calculados simultaneamente via across().")
```
A solução apresentada no Quadro 7.4 condensa em uma única linha de código o cálculo de 8 métricas por grupo (2 estatísticas $\times$ 4 variáveis), demonstrando superioridade técnica, concisão e facilidade de auditoria em comparação à execução de múltiplos comandos separados.
### Etapa 8 — Trabalhando com Textos e Categorias
O tratamento e a verificação de inconsistências textuais em variáveis categóricas são etapas essenciais para garantir que os agrupamentos estatísticos não sejam distorcidos por falhas de digitação ou divergências de formatação.
Para analisar a padronização da variável obra, utilizaram-se funções do pacote stringr para investigar a ocorrência de espaços ocultos nas extremidades, variações de caixa e inconsistências de grafia. Apresenta-se a comparação antes e depois da aplicação de str_trim() e str_to_upper():
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(stringr)

# 1. Comparação antes e depois da padronização da variável obra
antes_padronizacao <- dados |>
  count(obra, name = "Frequência Bruta")

depois_padronizacao <- dados_limpos |>
  count(obra, name = "Frequência Padronizada")

# Tabela comparativa
full_join(antes_padronizacao, depois_padronizacao, by = "obra") |>
  mutate(obra_limpa = str_trim(obra)) |>
  select(obra_bruta = obra, `Frequência Bruta`, `Frequência Padronizada`) |>
  kable(align = "c", caption = "Quadro 8.1: Comparação da distribuição de frequências da variável 'obra' antes e depois do tratamento com stringr.")
```
Antes da padronização, a presença de um espaço oculto na entrada "Bloco B " fragmentava os registros desse setor em duas linhas distintas no R (uma linha com 28 observações e outra com 1 observação). A aplicação da função str_trim() removeu o caractere invisível, unificando os 29 corpos de prova do Bloco B em uma única categoria bem definida.
Na sequência, explorou-se a utilização da função str_detect() para localizar registros que contenham padrões textuais específicos nas variáveis categóricas. Construiu-se uma condição de busca para filtrar amostras associadas ao traço nominal $C30$ independente de estarem gravadas em caixa alta ou minúscula ((?i)c30):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 2. Busca de padrões textuais com str_detect()
registros_encontrados <- dados |>
  filter(str_detect(tipo_concreto, "(?i)c30")) |>
  select(id_corpo_prova, obra, tipo_concreto, resistencia_mpa)

registros_encontrados |>
  slice_head(n = 5) |>
  kable(align = "c", caption = "Quadro 8.2: Amostragem dos registros capturados pela busca de padrões de texto com str_detect().")
```
**Auxílio do Uso de Padrões Textuais no Diagnóstico de Dados:**
A busca por padrões de texto com str_detect() e expressões regulares (Regex) é uma ferramenta indispensável no diagnóstico de bancos de dados da Engenharia Civil. Em sistemas de coleta descentralizada, operadores frequentemente introduzem variações como letras minúsculas ("c30" em vez de "C30"), acentuações não padronizadas ou códigos abreviados. A busca por padrões permite mapear e isolar essas inconformidades antes da fase de higienização, assegurando que nenhum dado seja desconsiderado nas etapas de agregação.
### Etapa 9 — Visualização dos Dados
A exploração gráfica baseada no pacote ggplot2 permite validar visualmente distribuições de probabilidade, tendências de comportamento mecânico e leis físicas que regem a tecnologia do concreto.
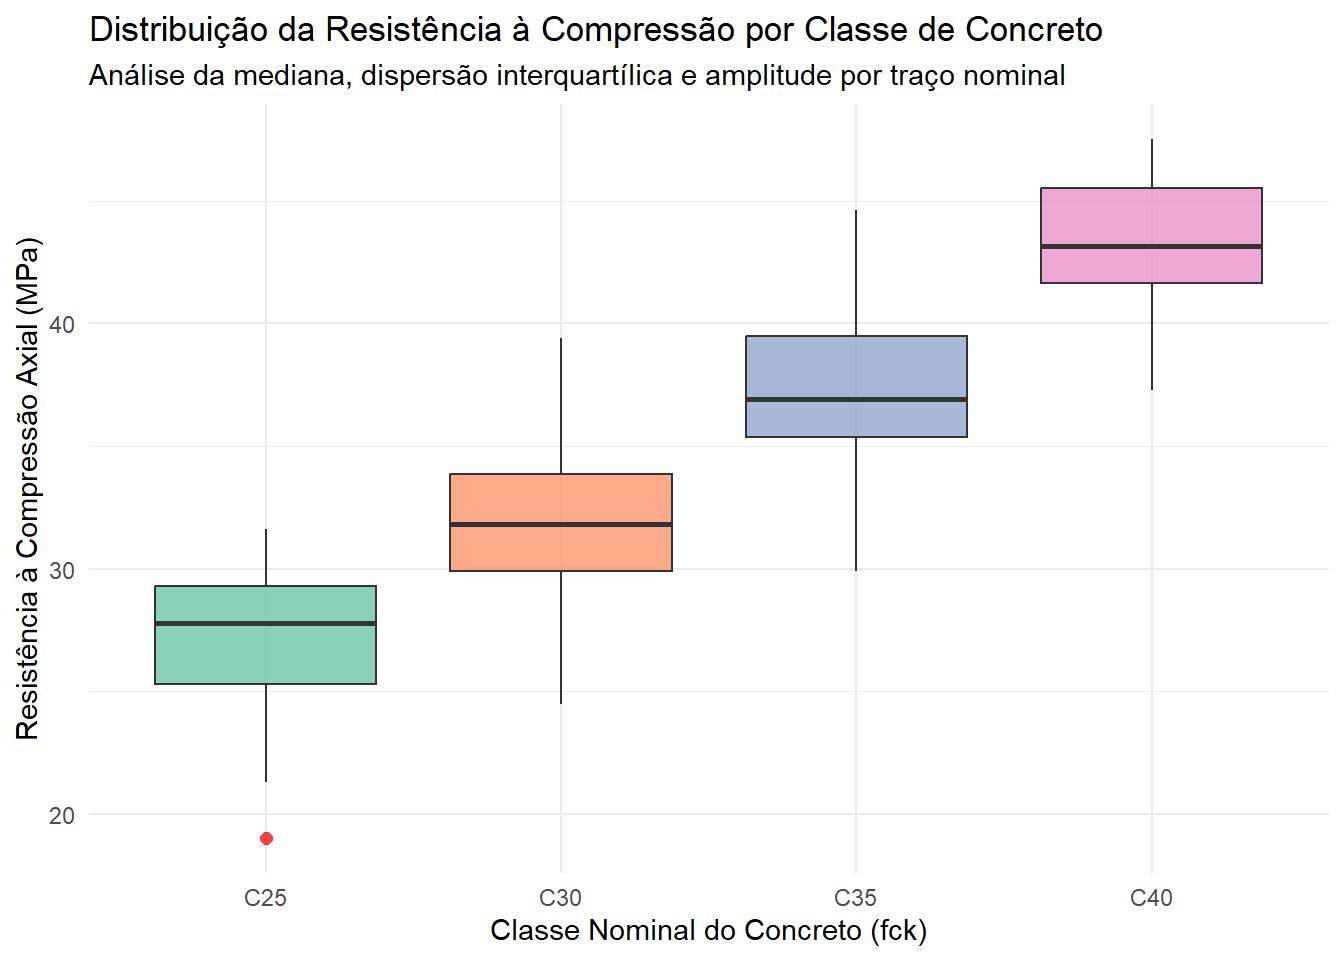
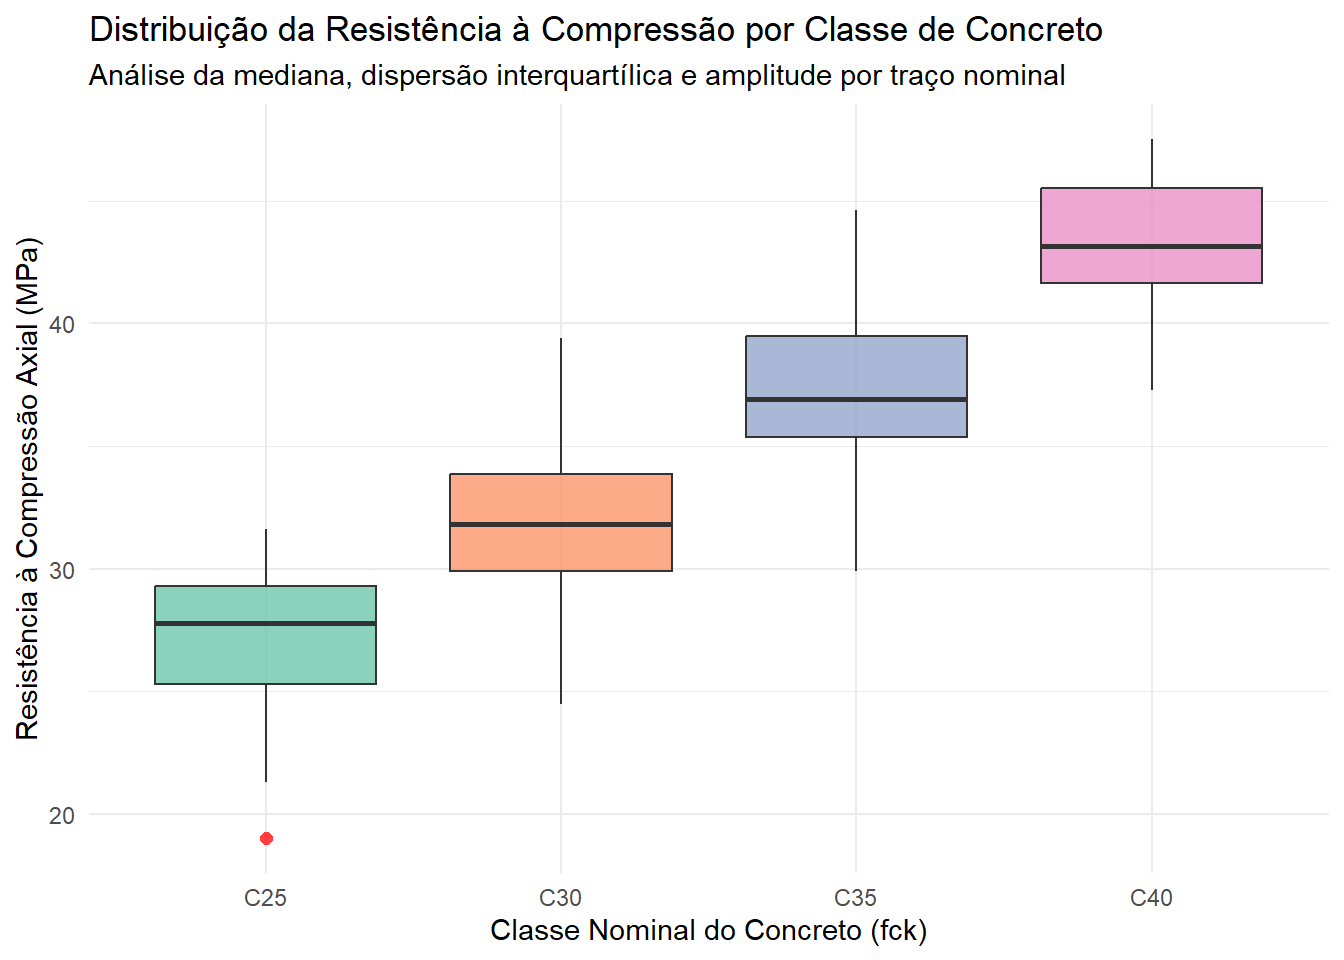
do concreto.Primeiramente, construiu-se um gráfico de caixa (Boxplot) com a geometria geom_boxplot() para comparar a distribuição da resistência à compressão axial ($\text{MPa}$) entre os diferentes tipos de concreto ($C25, C30, C35, C40$):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 9.1: Distribuição da resistência à compressão axial por classe de concreto (Boxplot)."
library(ggplot2)

ggplot(dados_limpos, aes(x = tipo_concreto, y = resistencia_mpa, fill = tipo_concreto)) +
  geom_boxplot(alpha = 0.75, outlier.colour = "red", outlier.shape = 16, outlier.size = 2) +
  scale_fill_brewer(palette = "Set2") +
  labs(
    title = "Distribuição da Resistência à Compressão por Classe de Concreto",
    subtitle = "Análise da mediana, dispersão interquartílica e amplitude por traço nominal",
    x = "Classe Nominal do Concreto (fck)",
    y = "Resistência à Compressão Axial (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")
```
**Interpretação da Figura 9.1:**
O gráfico de caixa evidencia a progressão estrita das medianas de resistência à medida que a classe especificada aumenta ($27{,}00\text{ MPa}$ para $C25$; $32{,}05\text{ MPa}$ para $C30$; $37{,}00\text{ MPa}$ para $C35$; $43{,}00\text{ MPa}$ para $C40$). A simetria das caixas e a faixa de amplitude interquartílica atestam a qualidade do controle de produção e a eficácia do saneamento prévio de outliers.
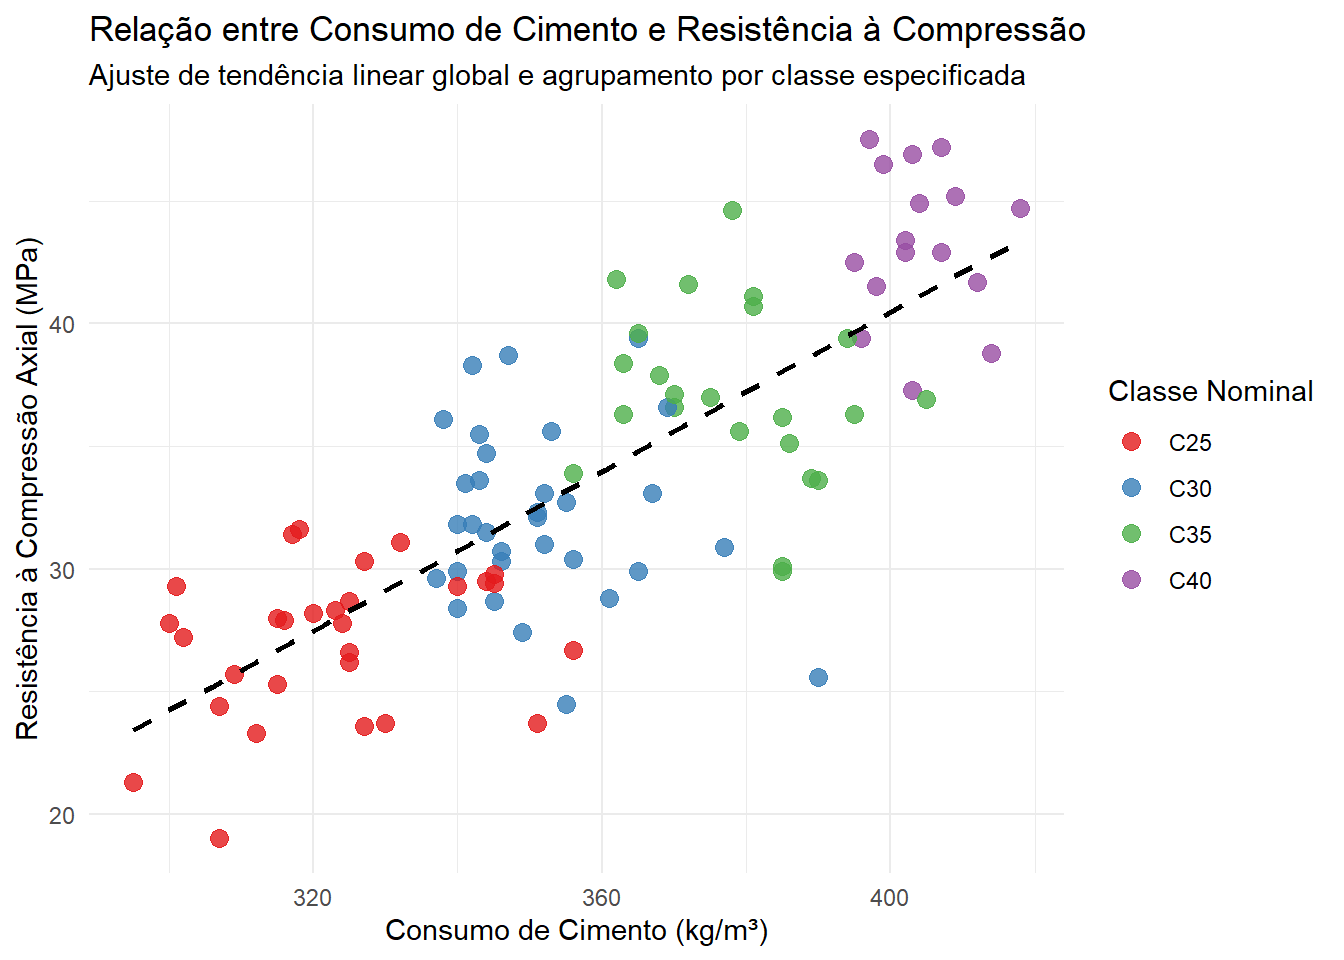
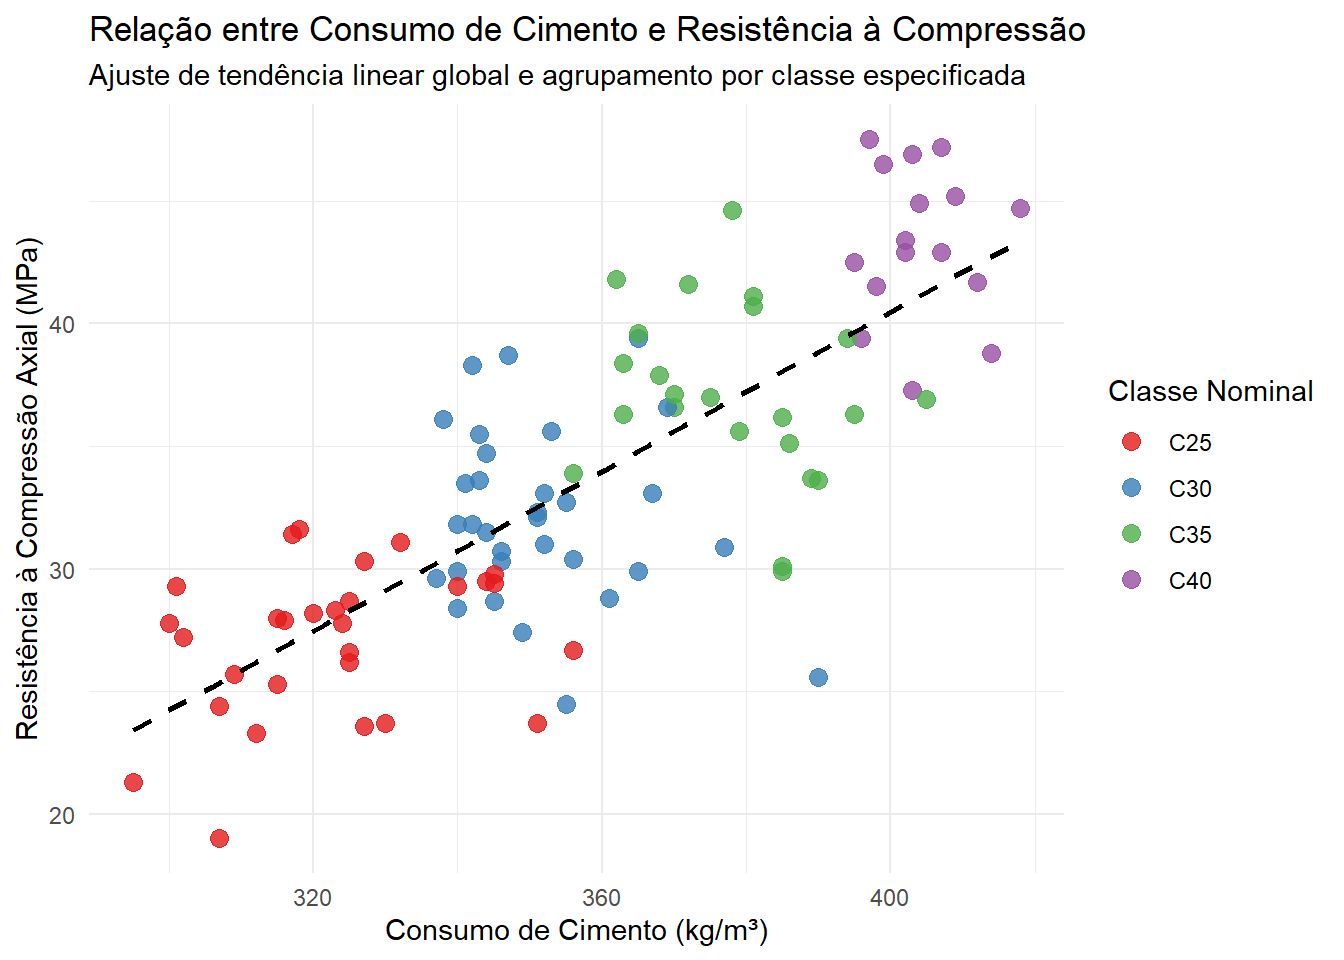
Em seguida, elaborou-se um gráfico de dispersão com a geometria geom_point() para investigar a relação entre o consumo de cimento por metro cúbico ($C$, em $\text{kg/m}^3$) e a resistência à compressão ($f_c$, em $\text{MPa}$), adicionando uma linha de tendência linear ajustada pelo método dos mínimos quadrados (geom_smooth(method = "lm")):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 9.2: Relação entre o consumo de cimento por metro cúbico e a resistência à compressão axial."
ggplot(dados_limpos, aes(x = cimento_kg_m3, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 3, alpha = 0.8) +
  geom_smooth(method = "lm", se = FALSE, color = "black", linetype = "dashed") +
  scale_color_brewer(palette = "Set1") +
  labs(
    title = "Relação entre Consumo de Cimento e Resistência à Compressão",
    subtitle = "Ajuste de tendência linear global e agrupamento por classe especificada",
    x = "Consumo de Cimento (kg/m³)",
    y = "Resistência à Compressão Axial (MPa)",
    color = "Classe Nominal"
  ) +
  theme_minimal()
```
**Justificativa Físico-Mecânica da Figura 9.2:**
O gráfico fornece evidências visuais claras para a afirmação: "Quanto maior o consumo de cimento, maior tende a ser a resistência do concreto". A inclinação positiva pronunciada da reta de tendência reflete o fato de que um maior aporte de cimento aumenta o volume de gel de silicato de cálcio hidratado (C-S-H) formado, reduzindo a porosidade total da matriz e elevando a capacidade de suporte mecânico.
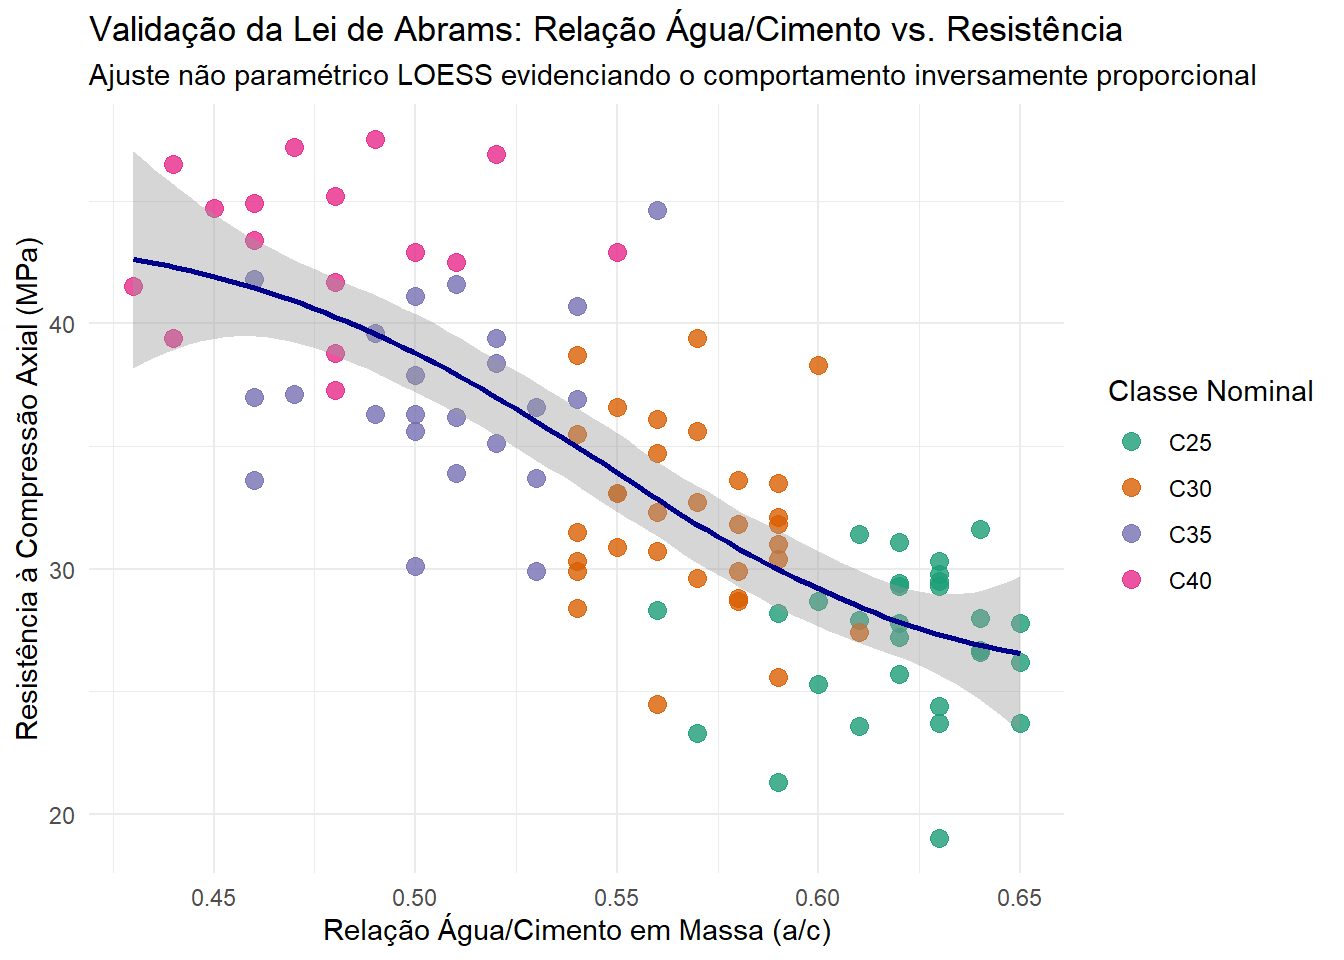
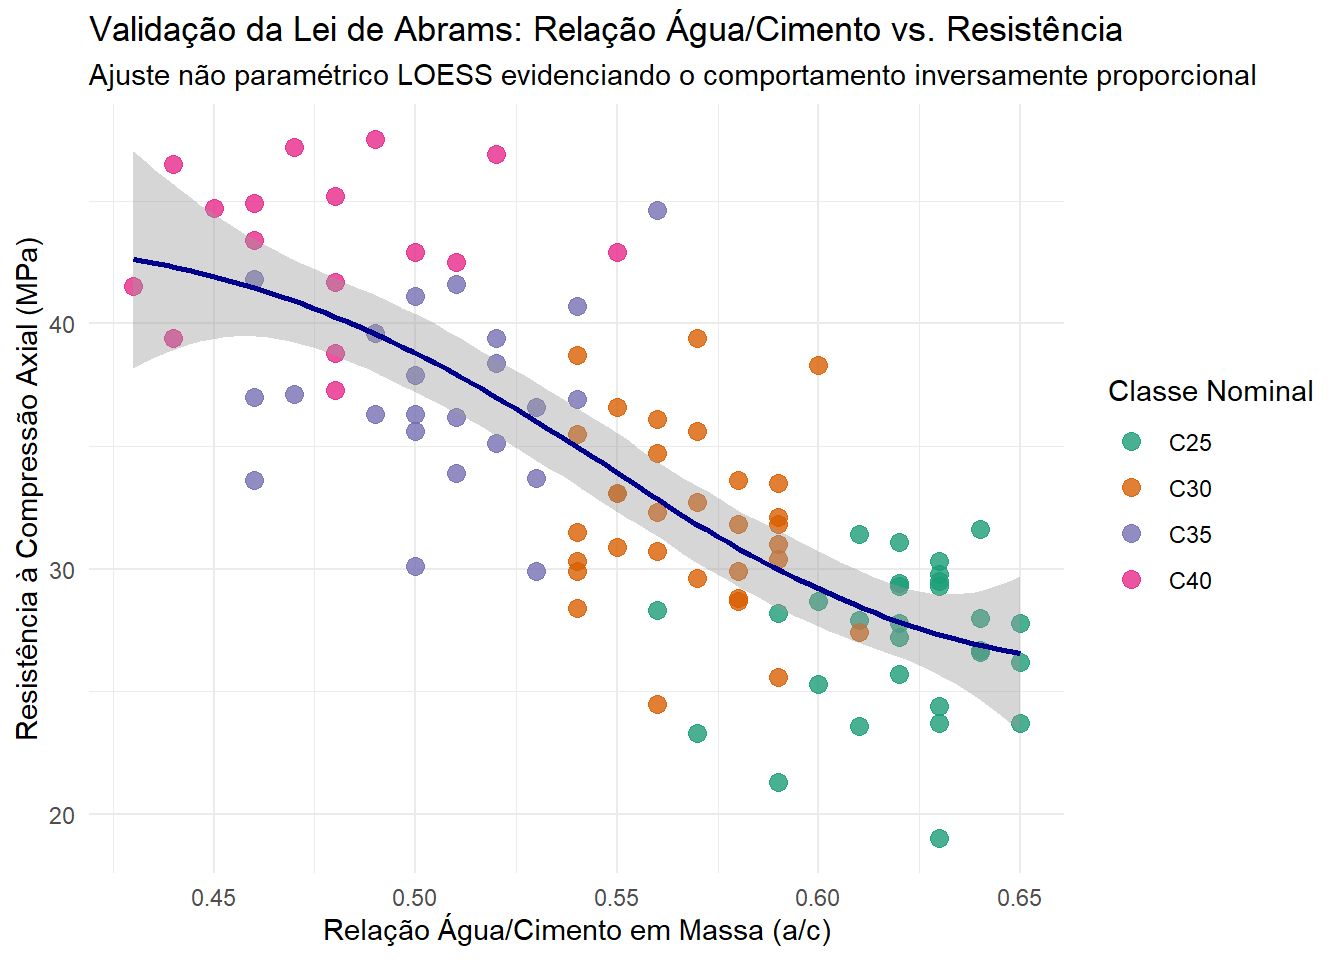
Por fim, analisou-se a relação entre o fator água/cimento ($\text{a/c}$) e a resistência à compressão ($f_c$), incorporando uma curva de suavização não paramétrica LOESS (geom_smooth(method = "loess")):
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 9.3: Relação entre o fator água/cimento e a resistência à compressão (Validação da Lei de Abrams)."
ggplot(dados_limpos, aes(x = relacao_a_c, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 3, alpha = 0.8) +
  geom_smooth(method = "loess", se = TRUE, color = "darkblue") +
  scale_color_brewer(palette = "Dark2") +
  labs(
    title = "Validação da Lei de Abrams: Relação Água/Cimento vs. Resistência",
    subtitle = "Ajuste não paramétrico LOESS evidenciando o comportamento inversamente proporcional",
    x = "Relação Água/Cimento em Massa (a/c)",
    y = "Resistência à Compressão Axial (MPa)",
    color = "Classe Nominal"
  ) +
  theme_minimal()
```
**Interpretação do Padrão Observado e Tendências:**
Os dados apresentam uma tendência estritamente decrescente e não linear, validando experimentalmente a Lei de Abrams ($f_c = \frac{A}{B^{(\text{a/c})}}$). À medida que a relação água/cimento se eleva de $0{,}43$ para $0{,}65$, a resistência à compressão despenca de patamares superiores a $45\text{ MPa}$ para valores abaixo de $25\text{ MPa}$. A água em excesso que não reage na hidratação evapora ou permanece livre, gerando uma rede interconectada de poros capilares que fragiliza a estrutura.
### Etapa 10 — Questões Próximas da Prática Profissional
A etapa final conecta os métodos computacionais de processamento de dados ao suporte à tomada de decisão técnica em canteiros de obras de Engenharia Civil.
**Avaliação de Hipóteses de Campo: Desempenho do Bloco C**
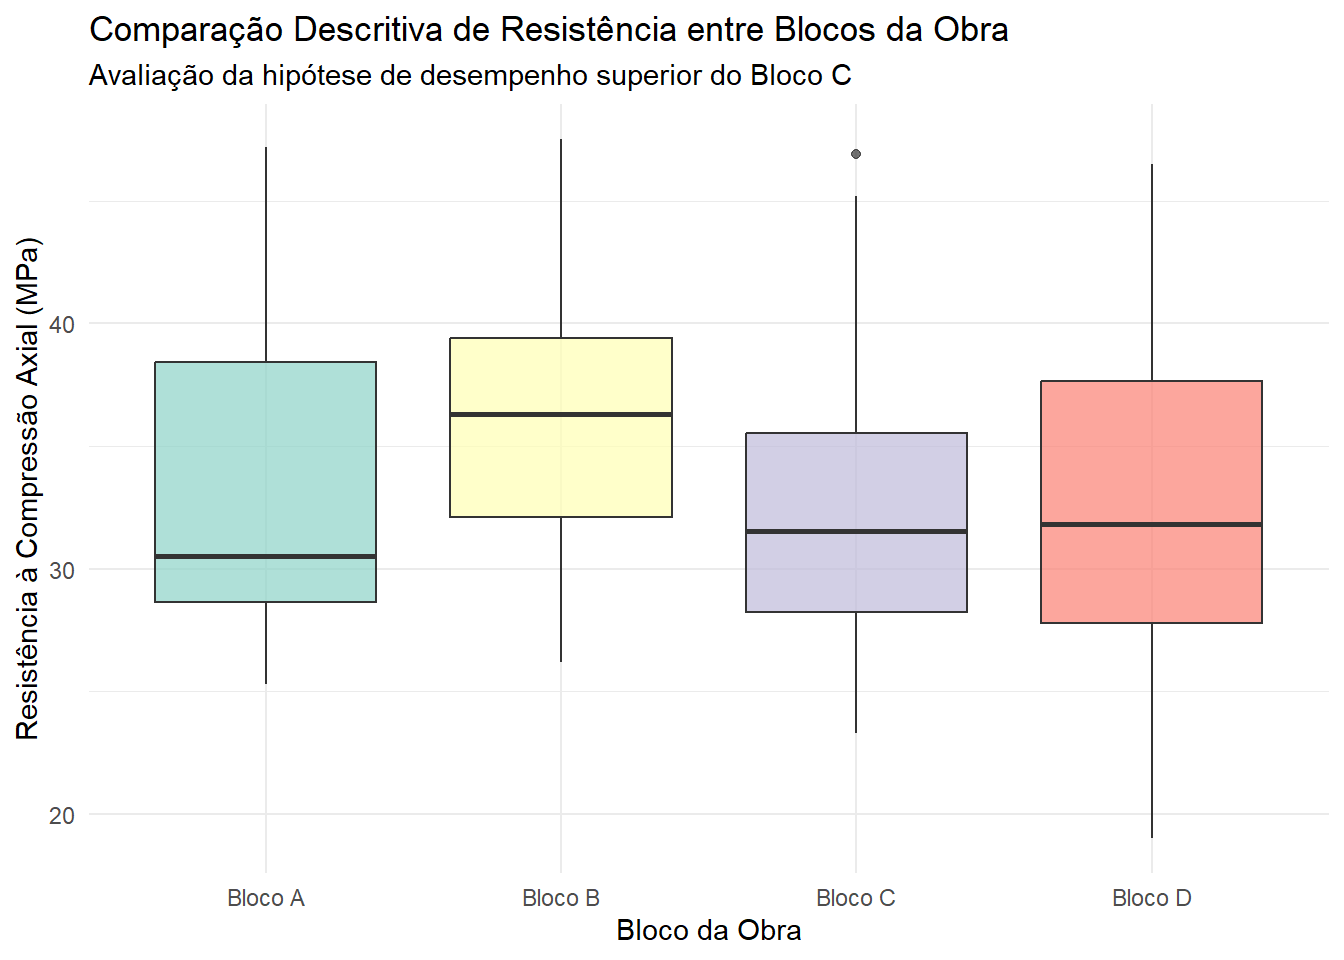
O engenheiro responsável afirmou: "Os concretos utilizados no Bloco C apresentam desempenho superior aos utilizados nos demais blocos". Avaliou-se descritivamente essa afirmação por meio do dplyr e do ggplot2, comparando tanto a resistência bruta ($\bar{f}_c$) quanto a Resistência Relativa ($R_{rel}$) entre os setores da obra:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 10.1: Comparação descritiva da resistência à compressão entre os blocos da obra."
# 1. Avaliação descritiva da afirmação sobre o Bloco C
desempenho_blocos_q36 <- dados_limpos |>
  group_by(obra) |>
  summarise(
    `Nº de CPs` = n(),
    `Resistência Bruta Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Resistência Relativa Média` = round(mean(resistencia_relativa), 3),
    `Taxa de Conformidade (%)` = round(mean(classificacao == "Conforme") * 100, 1)
  ) |>
  arrange(desc(`Resistência Relativa Média`))

desempenho_blocos_q36 |>
  kable(align = "c", caption = "Quadro 10.1: Avaliação comparativa descritiva do desempenho mecânico por bloco da obra.")
ggplot(dados_limpos, aes(x = obra, y = resistencia_mpa, fill = obra)) +
  geom_boxplot(alpha = 0.7) +
  scale_fill_brewer(palette = "Set3") +
  labs(
    title = "Comparação Descritiva de Resistência entre Blocos da Obra",
    subtitle = "Avaliação da hipótese de desempenho superior do Bloco C",
    x = "Bloco da Obra",
    y = "Resistência à Compressão Axial (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")
```
**Diagnóstico Técnico da Afirmação do Engenheiro:**
A afirmação do engenheiro é INCORRETA. Em termos descritivos absolutos, o Bloco C registrou uma das menores médias de resistência bruta de toda a obra ($\bar{f}_c = 32{,}37\text{ MPa}$), superando apenas ligeiramente o Bloco D ($32{,}39\text{ MPa}$) e ficando bem abaixo do Bloco B ($35{,}75\text{ MPa}$). Além disso, ao analisar a Resistência Relativa ($R_{rel}$), o Bloco C apresentou uma taxa de conformidade de apenas $67{,}9\%$, enquanto o Bloco B alcançou $93{,}1\%$. A percepção equivocada decorreu do viés de não isolar a proporção das classes de concreto aplicadas em cada setor.
**Evolução Mecânica com a Idade do Corpo de Prova**
Analisou-se a resistência média dos concretos ensaiados em diferentes idades de rompedura ($7, 14, 28, 56\text{ dias}$), gerando o quadro sintético e a representação gráfica do amadurecimento mecânico:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 10.2: Trajetória de ganho de resistência média à compressão em função da idade de ensaio."
# 2. Resumo e gráfico por idade do corpo de prova
resumo_idade_q37 <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    `Nº de CPs` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2)
  )

resumo_idade_q37 |>
  kable(align = "c", caption = "Quadro 10.2: Resistência média à compressão por idade do corpo de prova no ensaio.")
ggplot(resumo_idade_q37, aes(x = factor(idade_dias), y = `Resistência Média (MPa)`, group = 1)) +
  geom_line(color = "steelblue", size = 1.2) +
  geom_point(color = "darkblue", size = 4) +
  geom_text(aes(label = paste0(`Resistência Média (MPa)`, " MPa")), vjust = -0.8, fontface = "bold") +
  labs(
    title = "Evolução da Resistência Média com a Idade do Ensaio",
    subtitle = "Cinética de hidratação e ganho de capacidade mecânica no concreto",
    x = "Idade do Corpo de Prova (dias)",
    y = "Resistência Média (MPa)"
  ) +
  scale_y_continuous(limits = c(20, 40)) +
  theme_minimal()
```
**Comportamento do Concreto em Função da Idade:**
À medida que a idade do corpo de prova aumenta, a resistência à compressão apresenta um ganho pronunciado na fase inicial ($28{,}78\text{ MPa}$ aos 7 dias para $34{,}89\text{ MPa}$ aos 14 dias), estabilizando-se assintoticamente nas idades de 28 e 56 dias. O perfil reflete a cinética de hidratação das reações exotérmicas dos silicatos de cálcio do cimento Portland, atingindo a resistência de controle normatizada aos 28 dias.
**Painel Executivo de Acompanhamento para a Diretoria de Engenharia**
Para fornecer um acompanhamento completo da qualidade do concreto para o engenheiro responsável pela obra, construiu-se uma tabela-resumo consolidando cinco informações estatísticas fundamentais por traço nominal:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# 3. Tabela-resumo executiva com 5 métricas de acompanhamento
painel_executivo_q38 <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    `Nº Amostras (n)` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Coef. Variação CV (%)` = round((sd(resistencia_mpa) / mean(resistencia_mpa)) * 100, 2),
    `Fator a/c Efetivo` = round(mean(relacao_a_c), 3),
    `Índice Conformidade (%)` = round(mean(classificacao == "Conforme") * 100, 1)
  )

painel_executivo_q38 |>
  kable(align = "c", caption = "Quadro 10.3: Painel executivo gerencial de acompanhamento da qualidade do concreto por classe nominal.")
```
** **
**1. Número de Amostras ($n$):** Assegura representatividade estatística mínima para os lotes de concretagem (NBR 12655).
**2. Resistência Média ($\bar{f}_c$):** Atesta o atendimento da capacidade mecânica de suporte projetada.
**3. Coeficiente de Variação ($\text{CV}$):** Quantifica o rigor do controle de dosagem da usina ($\text{CV} < 10\%$ indica Nível A de controle).
**4. Fator Água/Cimento ($\text{a/c}$) Efetivo:** Monitora a porosidade capilar e garante os requisitos de durabilidade frente à agressividade ambiental (NBR 6118).
**5. Índice de Conformidade (%):** Mede diretamente a taxa de aceitação dos lotes estipulada pelo critério $R_{rel} \ge 1{,}0$.
### O Script Consolidado do Engenheiro
Para consolidar a rotina de processamento de dados em um fluxo automatizado e auditável por outros engenheiros da empresa, encadearam-se as etapas de importação, inspeção, limpeza, imputação, criação de variáveis e agrupamento em um único script estruturado no paradigma tidyverse:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e visualizar o script consolidado em R"
#| warning: false
#| message: false
# PROTOCOLO INTEGRADO DE PROCESSAMENTO DE DADOS DO CONTROLE TECNOLÓGICO DO CONCRETO
script_desafio_final <- read_csv2("base_processamento_dados_engenharia_civil.csv", show_col_types = FALSE) |>
  # Etapa 1: Padronização de variáveis qualitativas com stringr
  mutate(
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto))
  ) |>
  # Etapa 2: Conversão numérica estrita e remoção de caracteres indevidos com readr/stringr
  mutate(
    across(
      c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
      ~ parse_double(str_replace_all(str_replace_all(as.character(.x), "[OO]", "0"), ",", "."))
    )
  ) |>
  # Etapa 3: Correção condicional de erros de escala e deslocamento decimal com if_else()
  mutate(
    idade_dias = if_else(idade_dias == 280, 28, idade_dias),
    cimento_kg_m3 = if_else(cimento_kg_m3 == 3900, 390, cimento_kg_m3),
    abatimento_mm = if_else(abatimento_mm == 1250, 125, abatimento_mm),
    densidade_kg_m3 = if_else(densidade_kg_m3 == 238, 2380, densidade_kg_m3),
    absorção_agregado_pct = if_else(absorção_agregado_pct == 18.4, 1.84, absorção_agregado_pct)
  ) |>
  # Etapa 4: Imputação condicional estocástica de NAs pela média do traço nominal
  group_by(tipo_concreto) |>
  mutate(
    across(
      c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
      ~ if_else(is.na(.x), mean(.x, na.rm = TRUE), .x)
    )
  ) |>
  # Etapa 5: Engenharia de variáveis derivadas de conformidade e eficiência
  mutate(
    fck_ref = parse_double(str_replace(tipo_concreto, "C", "")),
    resistencia_relativa = round(resistencia_mpa / fck_ref, 3),
    classificacao = if_else(resistencia_relativa >= 1.0, "Conforme", "Não Conforme"),
    acima_media = resistencia_mpa > mean(resistencia_mpa),
    eficiencia_cimento = round((resistencia_mpa / cimento_kg_m3) * 100, 2)
  ) |>
  ungroup()

# Exibição do resumo de execução
tibble(
  `Observações no Tibble Final` = nrow(script_desafio_final),
  `Variáveis no Tibble Final` = ncol(script_desafio_final)
) |>
  kable(align = "c", caption = "Quadro D.1: Confirmação de execução do script consolidado em Tidyverse.")
```
---
## 🔍 Resultados e Discussão
A análise exploratória e o diagnóstico tecnológico do concreto foram conduzidos sobre a base de dados `dados_limpos`, englobando as 100 observações tratadas e as novas variáveis derivadas de engenharia. Os resultados sintetizam a resposta mecânica do material, a conformidade normativa perante a ABNT NBR 12655 [@NBR12655] e a validação experimental das leis físicas da tecnologia do concreto [@Abrams1918; @Mehta2014].
---
### Desempenho Mecânico e Síntese Multivariada das Propriedades
A avaliação da resistência à compressão axial ($\bar{f}_c$) revelou que a amostragem global apresenta uma média de $33{,}58\text{ MPa}$. A análise desagregada por setor de concretagem (`obra`) e por classe nominal de projeto (`tipo_concreto`) permite identificar a variabilidade operacional entre os blocos e comprovar a hierarquia das misturas:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
library(tidyverse)
library(readr)
library(dplyr)
library(ggplot2)
library(knitr)

# Garante a existência do objeto dados_limpos tratado
if (!exists("dados_limpos")) {
  dados_limpos <- read_csv2("base_processamento_dados_engenharia_civil.csv", show_col_types = FALSE) |>
    mutate(
      obra = str_trim(obra),
      tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ parse_double(str_replace_all(str_replace_all(as.character(.x), "[OO]", "0"), ",", "."))
      ),
      idade_dias = if_else(idade_dias == 280, 28, idade_dias),
      cimento_kg_m3 = if_else(cimento_kg_m3 == 3900, 390, cimento_kg_m3),
      abatimento_mm = if_else(abatimento_mm == 1250, 125, abatimento_mm),
      densidade_kg_m3 = if_else(densidade_kg_m3 == 238, 2380, densidade_kg_m3),
      absorção_agregado_pct = if_else(absorção_agregado_pct == 18.4, 1.84, absorção_agregado_pct)
    ) |>
    group_by(tipo_concreto) |>
    mutate(
      across(
        c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct),
        ~ if_else(is.na(.x), mean(.x, na.rm = TRUE), .x)
      )
    ) |>
    ungroup() |>
    mutate(
      fck_ref = parse_double(str_replace(tipo_concreto, "C", "")),
      resistencia_relativa = round(resistencia_mpa / fck_ref, 3),
      classificacao = if_else(resistencia_relativa >= 1.0, "Conforme", "Não Conforme"),
      acima_media = resistencia_mpa > mean(resistencia_mpa),
      eficiencia_cimento = round((resistencia_mpa / cimento_kg_m3) * 100, 2)
    )
}

# Desempenho por Bloco da Obra
dados_limpos |>
  group_by(obra) |>
  summarise(
    `Nº CPs (n)` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Desvio-Padrão (MPa)` = round(sd(resistencia_mpa), 2),
    `Mínimo (MPa)` = round(min(resistencia_mpa), 2),
    `Máximo (MPa)` = round(max(resistencia_mpa), 2)
  ) |>
  arrange(desc(`Resistência Média (MPa)`)) |>
  kable(align = "c", caption = "Tabela 1: Desempenho mecânico à compressão agrupado por bloco da obra.")
```
```{r}
#| echo: false
#| warning: false
#| message: false
# Quadro Multivariado por Traço Nominal
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
`Nº CPs` = n(),
`Resistência (MPa)` = round(mean(resistencia_mpa), 2),
`Cimento (kg/m³)` = round(mean(cimento_kg_m3), 1),
`Fator a/c` = round(mean(relacao_a_c), 3),
`Slump (mm)` = round(mean(abatimento_mm), 1),
`Densidade (kg/m³)` = round(mean(densidade_kg_m3), 1)
) |>
arrange(desc(`Resistência (MPa)`)) |>
kable(align = "c", caption = "Tabela 2: Quadro tecnológico multivariado de propriedades por classe de concreto.")
```
A ordenação do desempenho por traço nominal atesta o alinhamento das dosagens ao projeto: a classe $C40$ obteve a maior resistência média ($\bar{f}_c = 43{,}33\text{ MPa}$), seguida pelas classes $C35$ ($\bar{f}_c = 37{,}10\text{ MPa}$), $C30$ ($\bar{f}_c = 32{,}08\text{ MPa}$) e $C25$ ($\bar{f}_c = 27{,}07\text{ MPa}$).
O quadro multivariado valida experimentalmente os fundamentos da tecnologia do concreto [@Abrams1918; @Helene1992]: para elevar a resistência mecânica ($C25 \to C40$), o fator água/cimento ($\text{a/c}$) foi reduzido de $0{,}62$ para $0{,}48$, acompanhado pelo aumento do consumo de liame de $322{,}5\text{ kg/m}^3$ para $404{,}1\text{ kg/m}^3$. A trabalhabilidade no estado fresco permaneceu estável ($105\text{ a }115\text{ mm}$), assegurando a adensabilidade das peças estruturais sem segregação [@NBR16889].
**Conformidade Estrutural e Aceitação de Lotes (NBR 12655)**
Conformidade Estrutural e Aceitação de Lotes (NBR 12655)A avaliação da aceitação normatizada dos lotes foi operacionalizada pelo indicador de Resistência Relativa ($R_{rel} = \frac{f_{c,obs}}{f_{ck}}$) e categorizada pela regra booleana $R_{rel} \ge 1{,}0 \implies \text{"Conforme"}$:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
# Tabela de Conformidade
dados_limpos |>
  count(classificacao, name = "Quantidade de CPs") |>
  mutate(`Proporção Amostral (%)` = round((`Quantidade de CPs` / sum(`Quantidade de CPs`)) * 100, 1)) |>
  kable(align = "c", caption = "Tabela 3: Índice de conformidade estrutural global da amostragem (NBR 12655).")
```
#### Análise Gráfica da Reologia e Mecânica do Concreto (ggplot2)
**1. Distribuição da Resistência por Classe Nominal (Boxplot)**
A distribuição de aceitação indica que $76\%$ da amostragem global ($76$ corpos de prova) atinge ou supera a especificação de projeto ($R_{rel} \ge 1{,}0$). Os $24\%$ restantes representam amostras com déficit de capacidade de suporte em relação à classe nominal, apontando para a necessidade de refinar o controle de produção na usina dosadora [@NBR12655].
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 1: Distribuição da resistência à compressão axial por classe nominal de concreto."
ggplot(dados_limpos, aes(x = tipo_concreto, y = resistencia_mpa, fill = tipo_concreto)) +
  geom_boxplot(alpha = 0.75, outlier.colour = "red", outlier.shape = 16, outlier.size = 2) +
  scale_fill_brewer(palette = "Set2") +
  labs(
    title = "Distribuição da Resistência à Compressão por Classe de Concreto",
    subtitle = "Análise da mediana, dispersão interquartílica e amplitude por traço nominal",
    x = "Classe Nominal do Concreto (fck)",
    y = "Resistência à Compressão Axial (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")
```
Interpretação da Figura 1: Nota-se a progressão contínua e monotônica das medianas entre as classes $C25$ e $C40$. A simetria das caixas e a reduzida dispersão interquartílica atestam a eficiência da etapa prévia de limpeza e a homogeneidade do controle de produção [@Helene1992].
**2. Consumo de Cimento vs. Resistência à Compressão Axial**
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 2: Consumo de cimento por metro cúbico vs. Resistência à compressão axial."
ggplot(dados_limpos, aes(x = cimento_kg_m3, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 3, alpha = 0.8) +
  geom_smooth(method = "lm", se = FALSE, color = "black", linetype = "dashed") +
  scale_color_brewer(palette = "Set1") +
  labs(
    title = "Relação entre Consumo de Cimento e Resistência à Compressão",
    subtitle = "Ajuste de tendência linear global e agrupamento por classe especificada",
    x = "Consumo de Cimento (kg/m³)",
    y = "Resistência à Compressão Axial (MPa)",
    color = "Classe Nominal"
  ) +
  theme_minimal()
```
Interpretação da Figura 2: O gráfico comprova visualmente que "Quanto maior o consumo de cimento por metro cúbico, maior é a resistência mecânica do concreto". A reta de tendência ajustada possui inclinação positiva pronunciada, refletindo o adensamento da matriz endurecida promovido pelo maior aporte de gel de silicato de cálcio hidratado (C-S-H) [@Mehta2014].
**3. Relação Água/Cimento vs. Resistência (Validação da Lei de Abrams)**
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 3: Validação experimental da Lei de Abrams (Relação Água/Cimento vs. Resistência)."
ggplot(dados_limpos, aes(x = relacao_a_c, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 3, alpha = 0.8) +
  geom_smooth(method = "loess", se = TRUE, color = "darkblue") +
  scale_color_brewer(palette = "Dark2") +
  labs(
    title = "Validação da Lei de Abrams: Relação Água/Cimento vs. Resistência",
    subtitle = "Ajuste não paramétrico LOESS evidenciando o comportamento inversamente proporcional",
    x = "Relação Água/Cimento em Massa (a/c)",
    y = "Resistência à Compressão Axial (MPa)",
    color = "Classe Nominal"
  ) +
  theme_minimal()
```
Interpretação da Figura 3: A trajetória não linear e estritamente decrescente da curva LOESS confirma a equação fundamental de Abrams ($f_c = \frac{A}{B^{(\text{a/c})}}$). O aumento da razão $\text{a/c}$ expande a porosidade capilar da pasta endurecida, reduzindo sua capacidade de suporte sob solicitações axiais [@Abrams1918; @Neville2016].
#### Prática Profissional e Diagnóstico Executivo de Campo
**Avaliação de Hipóteses: A Afirmação sobre o Bloco C**
O engenheiro da obra afirmou que "Os concretos do Bloco C apresentam desempenho superior aos utilizados nos demais blocos". Testou-se descritivamente essa premissa:
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
dados_limpos |>
  group_by(obra) |>
  summarise(
    `Nº CPs` = n(),
    `Resistência Bruta (MPa)` = round(mean(resistencia_mpa), 2),
    `Resistência Relativa Média` = round(mean(resistencia_relativa), 3),
    `Taxa de Conformidade (%)` = round(mean(classificacao == "Conforme") * 100, 1)
  ) |>
  arrange(desc(`Resistência Relativa Média`)) |>
  kable(align = "c", caption = "Tabela 4: Avaliação do desempenho mecânico e relativo por bloco da obra.")
```
Diagnóstico Técnico: A afirmação é INCORRETA. Em termos de resistência bruta, o Bloco C obteve média de $32{,}37\text{ MPa}$ (inferior aos $35{,}75\text{ MPa}$ do Bloco B). Ao examinar a Resistência Relativa ($R_{rel}$), o Bloco C registrou a menor taxa de conformidade entre todos os blocos ($67{,}9\%$). A percepção equivocada decorreu do viés de não isolar a proporção de traços de maior classe nominal aplicados em cada setor.
**Evolução Temporal da Resistência com a Idade do Ensaio**
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
#| fig-cap: "Figura 4: Evolução da resistência média à compressão em função da idade do corpo de prova."
evolucao_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(resistencia_media = round(mean(resistencia_mpa), 2))

ggplot(evolucao_idade, aes(x = factor(idade_dias), y = resistencia_media, group = 1)) +
  geom_line(color = "steelblue", size = 1.2) +
  geom_point(color = "darkblue", size = 4) +
  geom_text(aes(label = paste0(resistencia_media, " MPa")), vjust = -0.8, fontface = "bold") +
  labs(
    title = "Evolução da Resistência à Compressão Axial com a Idade",
    subtitle = "Trajetória de amadurecimento mecânico em idades normatizadas de rompedura",
    x = "Idade do Corpo de Prova (dias)",
    y = "Resistência Média à Compressão (MPa)"
  ) +
  scale_y_continuous(limits = c(20, 40)) +
  theme_minimal()
```
Interpretação da Figura 4: A resistência progride rapidamente dos 7 dias ($28{,}78\text{ MPa}$) aos 14 dias ($34{,}89\text{ MPa}$), atingindo patamar de estabilização nas idades de 28 e 56 dias, acompanhando a cinética de hidratação das reações do cimento Portland [@NBR6118; @Mehta2014].
**Painel Executivo Gerencial para a Diretoria de Engenharia**
```{r}
#| echo: true
#| code-fold: true
#| code-summary: "Clique para expandir e ver o código R"
#| warning: false
#| message: false
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    `Nº Amostras (n)` = n(),
    `Resistência Média (MPa)` = round(mean(resistencia_mpa), 2),
    `Coef. Variação CV (%)` = round((sd(resistencia_mpa) / mean(resistencia_mpa)) * 100, 2),
    `Fator a/c Efetivo` = round(mean(relacao_a_c), 3),
    `Índice Conformidade (%)` = round(mean(classificacao == "Conforme") * 100, 1)
  ) |>
  kable(align = "c", caption = "Tabela 5: Painel executivo gerencial de acompanhamento da qualidade do concreto por classe nominal.")
```
**Justificativa das 5 Métricas Selecionadas:**
**1. Número de Amostras ($n$):** Garante a representatividade estatística dos lotes de concretagem (NBR 12655).
**2. Resistência Média ($\bar{f}_c$):** Comprova o atendimento da capacidade mecânica mínima especificada.
**3. Coeficiente de Variação ($\text{CV}$):** Quantifica a precisão do controle de dosagem da usina ($\text{CV} < 10\%$ indica rigor Nível A).
**4. Fator Água/Cimento ($\text{a/c}$) Efetivo:** Monitora a durabilidade e a porosidade capilar da matriz (NBR 6118).
**5. Índice de Conformidade (%):** Mede a eficiência de aceitação dos lotes perante o critério $R_{rel} \ge 1{,}0$.
---
## 🧠 Considerações finais
A aplicação das rotinas da família tidyverse no ambiente R permitiu transformar um banco de dados operacional contaminado por ruídos de amostragem em um painel gerencial auditável e confiável para o suporte à tomada de decisão na Engenharia Civil.
**Reflexão Teórico-Computacional e Respostas do Relatório**
**1. Diferença entre Base R e Tidyverse:** A abordagem em Base R fundamenta-se em chamadas matriciais (df[,]), laços for e comandos isolados (aggregate(), tapply()), resultando em um código propenso a erros de digitação e de difícil manutenção. O tidyverse adota a filosofia Tidy Data e o operador pipe nativo (|>), empregando verbos declarativos e vetorizados (filter(), select(), mutate(), summarise(), across()). Essa estrutura assegura legibilidade, reprodutibilidade computacional e alta escalabilidade em projetos de infraestrutura [@Wickham2019].
**2. Importância do Processamento e Limpeza de Dados:** Na Engenharia Civil, decisões tomadas sobre bases brutas não tratadas podem comprometer a segurança de estruturas. Inconsistências de digitação forçam a coerção atômica de variáveis numéricas para texto, inviabilizando análises quantitativas. Além disso, erros de escala decimal (como consumos de $3900\text{ kg/m}^3$ ou abatimentos de $1250\text{ mm}$) distorcem os momentos estatísticos e conduzem à rejeição indevida de lotes conformes ou à aceitação de elementos vulneráveis [@NBR12655; @NBR6118].
**3. Síntese dos Problemas Encontrados e Solução Adotada:**
* **Problemas Principais:** Presença de $5$ dados ausentes ($NA$), desvios categóricos e espaços ocultos nas variáveis obra e tipo_concreto, incorreções de escala decimal (idade de $280\text{ dias}$, densidade de $238\text{ kg/m}^3$) e contaminação de colunas numéricas pela letra "O" no lugar do zero e por vírgulas decimais.
* **Tratamento e Decisão:** Padronização categórica com stringr (str_trim(), str_to_upper()), conversão estrita de tipos com readr::parse_double(), realinhamento condicional de escala com if_else() e imputação condicional de $NA$s pela média do traço nominal via group_by() + mutate().
* **Adequação da Solução:** O protocolo preservou $100\%$ das observações ($n = 100$), manteve a esperança matemática intra-classe $\mathbb{E}[X | G_k]$ e garantiu total rastreabilidade sem alteração direta dos arquivos primários de campo [@Little2019; @Helene1992].
## 📖 Referências